

Một buổi sáng thứ Hai, máy chủ chạy phần mềm bán hàng của một cửa hàng gặp lỗi ổ cứng và không khởi động lại được. Đội kỹ thuật mở bản sao lưu gần nhất, và tệp không đọc được. Lần sao lưu đó đã lỗi từ vài tuần trước, nhưng không ai nhận được cảnh báo, vì chưa ai từng thử khôi phục từ bản sao ấy. Tình huống này là minh hoạ, không lấy từ một khách hàng cụ thể của MONA, nhưng kiểu mất dữ liệu như vậy gặp khá thường xuyên ở những hệ thống chỉ được kiểm tra khi sự cố đã xảy ra.
Câu trả lời ngắn: một bản sao lưu chỉ có giá trị khi khôi phục được từ nó, trong khoảng thời gian doanh nghiệp chấp nhận. Muốn đạt điều đó, doanh nghiệp cần ba việc. Một là đặt hai con số: mất tối đa bao nhiêu dữ liệu (RPO) và chạy lại tối đa sau bao lâu (RTO). Hai là thử khôi phục theo lịch và ghi kết quả. Ba là giữ bản sao ở chỗ khác với máy chủ chính. Các phần dưới giải thích từng việc, dựa trên NIST SP 800-34 Rev.1 về lập kế hoạch dự phòng và tài liệu sao lưu chính thức của PostgreSQL, cả hai đều kiểm ngày 14/10/2026.
RPO và RTO cần ai đó trong doanh nghiệp quyết định
NIST SP 800-34 Rev.1 định nghĩa RTO là khoảng thời gian tối đa một tài nguyên hệ thống có thể ngừng hoạt động, trước khi gây tác động không chấp nhận được lên các tài nguyên khác, lên quy trình nghiệp vụ được hỗ trợ và lên thời gian gián đoạn tối đa (MTD). RPO là thời điểm trước sự cố mà dữ liệu nghiệp vụ còn khôi phục được, dựa trên bản sao lưu gần nhất. Nói ngắn gọn, RTO đo thời gian máy không chạy được, còn RPO đo lượng dữ liệu có thể mất. Định nghĩa nằm ở mục 3.2.1, trang 17 theo số trang in của tài liệu.
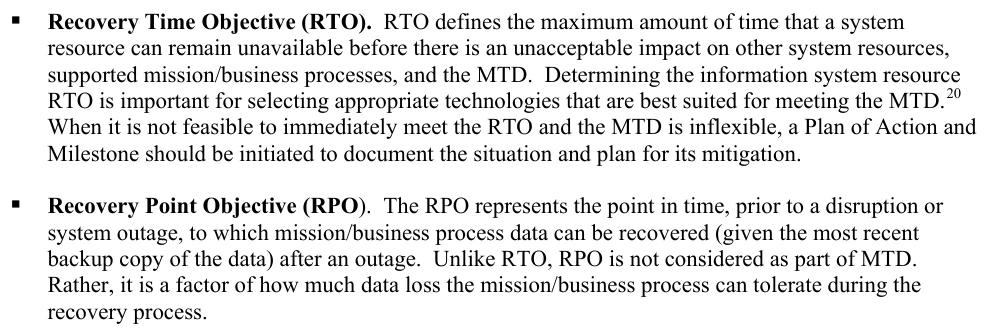
Điểm dễ bị bỏ qua là ai đặt con số. NIST không đưa RPO hay RTO chung để áp dụng cho mọi hệ thống. Theo cùng mục 3.2.1, việc xác định thời gian gián đoạn chấp nhận được thuộc về chủ quy trình, lãnh đạo và quản lý nghiệp vụ, làm cùng với phân tích tác động. Đội kỹ thuật nhận con số đó, rồi chọn công nghệ sao lưu và cách khôi phục để đạt được nó. Nếu đội kỹ thuật tự đặt RPO là 24 giờ mà phòng bán hàng không biết, con số đó không khớp với một ngày bán hàng mà doanh nghiệp không chấp nhận mất.
Ví dụ cụ thể: nếu doanh nghiệp không chấp nhận mất quá một giờ đơn hàng, RPO là một giờ, và bản sao phải được tạo ít nhất mỗi 1 giờ một lần. Nếu chủ quy trình chấp nhận ngừng bán tối đa nửa ngày, RTO là nửa ngày, và toàn bộ việc chuẩn bị máy thay, cài đặt, khôi phục dữ liệu và kiểm tra phải xong trong khoảng đó. Trước khi chốt RPO, cần biết dữ liệu nào thuộc quy trình nào. Nếu đang sắp xếp lại dữ liệu, xem thêm quản lý dữ liệu là gì và cách quản lý dữ liệu trong doanh nghiệp.
Ba kiểu sao lưu khác nhau ở chỗ nào
NIST mô tả ba cách sao lưu phổ biến: đầy đủ, gia tăng và vi sai, trong chương 5, trang 44 đến 45. Bảng dưới tóm lại đánh đổi của từng kiểu theo đúng mô tả trong tài liệu. Chọn kiểu nào là câu hỏi về việc khôi phục cần bao nhiêu bản rời rạc và mất bao lâu, không chỉ là tiết kiệm dung lượng.
| Kiểu sao lưu | Bản sao chứa gì | Thời gian chạy sao lưu | Khi khôi phục cần |
|---|---|---|---|
| Đầy đủ | Toàn bộ tệp trong thư mục hoặc ổ đã chọn | Lâu nhất trong ba kiểu | Một bộ bản sao đầy đủ |
| Gia tăng | Chỉ tệp được tạo mới hoặc đổi từ lần sao lưu trước, bất kể lần đó là kiểu nào | Ngắn nhất trong ba kiểu | Bản đầy đủ gần nhất và mọi bản gia tăng sau nó, đủ tất cả |
| Vi sai | Tệp được tạo mới hoặc đổi từ lần đầy đủ gần nhất | Ngắn hơn đầy đủ, nhưng dài hơn gia tăng, và dài dần mỗi ngày | Bản đầy đủ gần nhất và bản vi sai mới nhất |
Bản gia tăng ít tốn chỗ và chạy nhanh nhất, nhưng khôi phục cần nhiều bản rời rạc hơn, nên một bản hỏng trong chuỗi làm việc khôi phục khó hơn. Bản vi sai nằm giữa: mỗi lần chạy dài hơn lần trước, cho đến khi có lần đầy đủ mới. NIST đưa một cách kết hợp làm ví dụ: sao lưu đầy đủ vào cuối tuần, rồi vi sai vào mỗi buổi tối.
Bảng trên không có cột RPO vì NIST không đưa con số cho từng kiểu. RPO phụ thuộc vào thời điểm của bản sao gần nhất khôi phục được. Một bản đầy đủ mỗi đêm cho RPO tối đa khoảng 24 giờ, với điều kiện lần chạy đó thành công. Đó là lý do một lịch sao lưu chạy đều đặn nhưng không ai kiểm tra kết quả vẫn cho RPO thực tế dài hơn nhiều so với con số trên giấy.
Hai cách sao lưu PostgreSQL: pg_dump và lưu trữ WAL
PostgreSQL là ví dụ rõ cho hai cách làm khác nhau. Cách thứ nhất là pg_dump, ghi cơ sở dữ liệu thành các lệnh SQL và mặc định in ra đầu ra chuẩn. Theo mục 25.1 trong tài liệu sao lưu của PostgreSQL, bản dump là ảnh chụp nhất quán tại thời điểm pg_dump bắt đầu chạy. Trong lúc chạy, pg_dump không khoá các thao tác khác trên cơ sở dữ liệu. Ngoại lệ là những thao tác cần khoá độc quyền, ví dụ một số dạng ALTER TABLE.
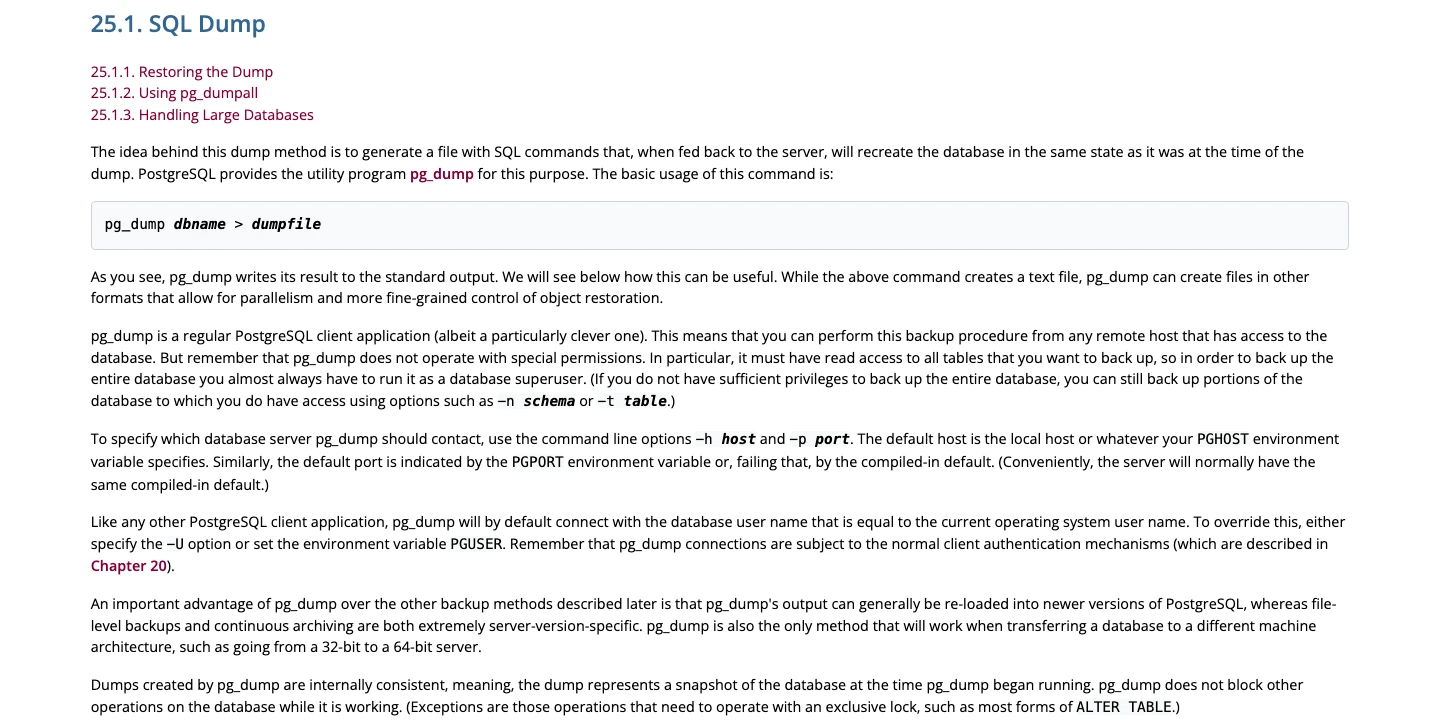
Hệ quả trực tiếp: mọi thay đổi xảy ra sau thời điểm dump không nằm trong bản đó. Nếu pg_dump chạy lúc 2 giờ sáng và sự cố xảy ra lúc 9 giờ sáng, dữ liệu nhập trong 7 giờ đó không có trong bản dump. Đây là suy luận từ mô tả snapshot của tài liệu, không phải một con số đo.
Tài liệu cũng ghi cặp lệnh cho bản dạng custom:
pg_dump -Fc dbname > filename
pg_restore -d dbname filename
Bản dạng văn bản SQL khôi phục bằng psql. Cơ sở dữ liệu phải được tạo trước bằng createdb -T template0 dbname, rồi mới chạy psql -X dbname < dumpfile. Bản custom không phải kịch bản cho psql, nên phải dùng pg_restore. Chạy thử cả hai đường khôi phục trên máy riêng là cách chắc nhất để biết lệnh nào thực sự chạy trong môi trường của doanh nghiệp. Khi cân nhắc giữa PostgreSQL và SQL Server, công cụ sao lưu đi kèm là một tiêu chí, xem thêm SQL Server hay PostgreSQL cho phần mềm quản trị.
Lưu trữ WAL giúp khôi phục về thời điểm gần sự cố hơn
Cách thứ hai là lưu trữ WAL. PostgreSQL ghi nhật ký WAL cho mọi thay đổi trên các tệp dữ liệu. Tài liệu về lưu trữ liên tục mô tả cách kết hợp một bản sao lưu cấp hệ thống tệp (base backup) với các tệp WAL được lưu lại. Khi cần khôi phục, máy phục hồi bản base backup rồi phát lại WAL để đưa hệ thống về trạng thái gần nhất. Theo tài liệu, cách này hỗ trợ khôi phục về bất kỳ thời điểm nào kể từ khi base backup được tạo.
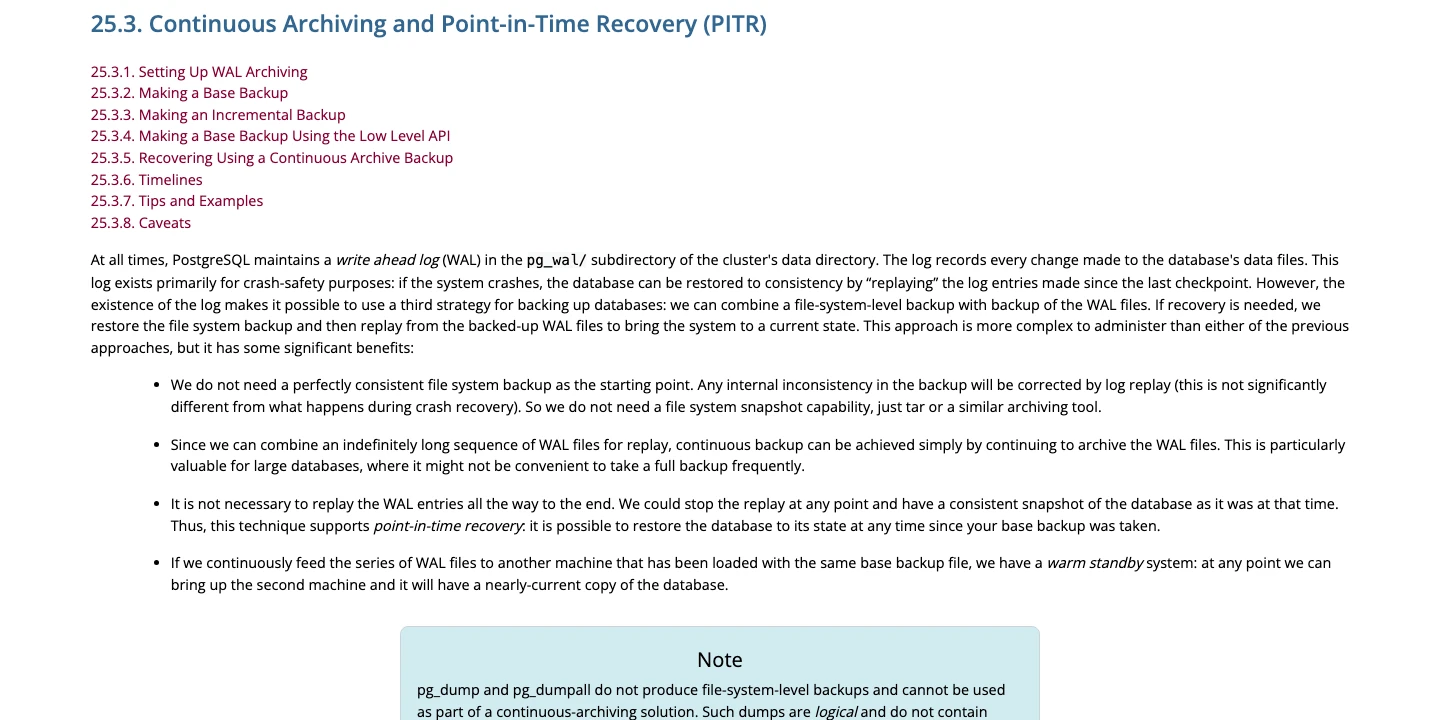
Đổi lại, mục 25.3 nói cách này phức tạp hơn để vận hành so với hai cách trước. Nó cũng đặt hai điều kiện rõ ràng. Thứ nhất, lệnh archive_command phải trả về mã thoát bằng 0 khi và chỉ khi việc lưu WAL thực sự thành công. Một lệnh báo thành công trong khi tệp WAL không được lưu là cách làm mất khả năng khôi phục mà không ai biết cho đến lúc cần đến nó. Thứ hai, quy trình lưu WAL phải được thiết lập và thử trước khi chụp base backup đầu tiên.
Phần vận hành này cũng kéo theo việc giữ phiên bản PostgreSQL còn được vá bảo mật. Vòng đời hỗ trợ của PostgreSQL và các ngôn ngữ phổ biến được tổng hợp trong bài phiên bản PHP, Node.js, Python, PostgreSQL còn vá bảo mật tới khi nào.
Bản sao chưa thử khôi phục thì chưa được tính là có
NIST coi kiểm thử là một phần thiết yếu của khả năng dự phòng, vì nó cho thấy điểm yếu của kế hoạch trước khi sự cố xảy ra. Mục 3.5.1, trang 27, yêu cầu mỗi thành phần hệ thống được thử để xác nhận thủ tục khôi phục đúng. Các nội dung cần kiểm gồm thông báo, khôi phục hệ thống trên nền tảng thay thế từ bản sao lưu, kết nối trong và ngoài, hiệu năng trên thiết bị thay thế, và đưa hoạt động trở lại bình thường.
Theo NIST, kế hoạch thử phải có mục tiêu và tiêu chí thành công cụ thể, và kịch bản nên giống thực tế càng sát càng tốt. Kết luận rút ra khá đơn giản: một tệp sao lưu nằm trong thư mục không chứng minh được điều gì về việc hệ thống chạy lại được. Chỉ một lần khôi phục thật, có đo thời gian và có kiểm dữ liệu, mới chứng minh được điều đó. Với phần mềm mới dựng bằng AI, khoảng cách giữa chạy được trên máy và chạy thật thường nằm đúng ở chỗ này. Bài từ vibe coding lên hệ thống chạy thật bàn các việc cần làm trước khi mở cho người dùng thật. Kiểm tra bảo mật là một phần khác của nghiệm thu, xem kiểm tra bảo mật phần mềm trước nghiệm thu theo OWASP.
Quy trình thử khôi phục định kỳ gồm các bước nào
Quy trình dưới đây gồm 7 bước theo thứ tự, mỗi bước tạo ra một kết quả đo được để so với RPO và RTO đã đặt. Chạy trên máy thử riêng, không nối vào hệ thống đang sản xuất.
- Ghi lại bản sao sẽ thử: thời điểm tạo, nơi lưu, kiểu sao lưu và dung lượng.
- Dựng một máy thử riêng, không kết nối với hệ thống đang chạy và không ghi đè dữ liệu thật.
- Khôi phục bản sao lên máy thử, ghi giờ bắt đầu và giờ hệ thống trả lời được yêu cầu đầu tiên.
- Đối chiếu dữ liệu: số bản ghi, tổng số tiền và bản ghi mới nhất phải khớp với thời điểm đã ghi ở bước 1.
- Chạy ba thao tác nghiệp vụ thật: đăng nhập, mở một chứng từ, xuất một báo cáo.
- So thời gian đo được ở bước 3 với RTO, và khoảng dữ liệu thiếu với RPO. Nếu lệch, ghi thành việc cần sửa, kèm người nhận và hạn.
- Lưu biên bản thử, rồi đặt lịch cho lần kế tiếp.
Các bước này bám theo yêu cầu của NIST về mục tiêu và tiêu chí thành công của kế hoạch thử. Tài liệu không nêu tần suất thử. Câu hỏi về tần suất được trả lời ở phần hỏi đáp bên dưới.
Đặt bản sao ở chỗ khác với máy chủ chính
NIST viết rằng việc lưu dữ liệu sao lưu ở một địa điểm khác là thực hành kinh doanh tốt (mục 3.4.2, trang 21). Các cơ sở lưu trữ chuyên dụng được thiết kế để bảo vệ phương tiện lưu trữ khỏi các yếu tố đe doạ. Chính sách sao lưu cũng nên ghi rõ vị trí lưu dữ liệu, quy ước đặt tên tệp, tần suất luân chuyển phương tiện và cách vận chuyển bản sao đi nơi khác.
Khi bản sao nằm trên cùng ổ hoặc cùng máy với dữ liệu đang chạy, một lỗi phần cứng làm mất cả hai. Nếu bản sao được mã hoá khi đưa đi nơi khác, NIST nhắc thêm hai việc. Khoá phải được quản lý riêng, tách khỏi bản sao mã hoá nhưng vẫn truy cập được khi cần. Và thiết bị đọc phương tiện phải có sẵn ở nơi khôi phục, nếu không bản sao mã hoá cũng không đọc được.
Hỏi đáp
Doanh nghiệp nhỏ có cần đặt RPO và RTO không?
Vẫn cần, chỉ là con số có thể đơn giản. NIST gắn RTO và RPO với quy trình nghiệp vụ và tác động của việc gián đoạn. Doanh nghiệp nhỏ chỉ cần trả lời hai câu: một ngày làm việc mất dữ liệu có chấp nhận được không, và máy ngừng bao lâu thì việc bán hàng ngưng đến mức nào. Hai câu trả lời đó là RPO và RTO.
Sao lưu mỗi ngày một lần đã đủ chưa?
Chỉ đủ khi RPO của doanh nghiệp là một ngày trở lên. Nếu một ngày nhập liệu không chấp nhận được, sao lưu mỗi ngày một lần là không đủ. Lịch sao lưu phải đặt theo RPO, không theo thói quen cũ. Ngoài ra, một lần sao lưu lỗi trong đêm làm RPO thực tế dài hơn lịch đã đặt, nên cần có thông báo khi sao lưu không thành công.
pg_dump có khôi phục được mọi thay đổi đến lúc sự cố không?
Không, nếu chỉ dùng pg_dump. Theo tài liệu PostgreSQL, bản dump là ảnh chụp tại thời điểm pg_dump bắt đầu chạy, nên các thay đổi sau thời điểm đó không có trong bản dump. Muốn khôi phục gần hơn tới lúc sự cố, cần kết hợp base backup với lưu trữ WAL, và phải chấp nhận rằng tài liệu mô tả cách này phức tạp hơn để vận hành.
Có nên giữ bản sao trên cùng máy chủ với dữ liệu không?
Không nên giữ bản sao duy nhất ở đó. NIST coi việc lưu bản sao ở một địa điểm khác là thực hành tốt, và yêu cầu chính sách sao lưu ghi rõ nơi lưu. Khi bản sao được mã hoá để đưa đi, khoá cần được quản lý riêng và vẫn truy cập được khi khôi phục.
Bao lâu thì thử khôi phục một lần?
Tài liệu NIST và PostgreSQL đều không đưa một tần suất chung. Điều NIST yêu cầu là kế hoạch thử có mục tiêu, tiêu chí thành công và kịch bản gần thực tế. Tần suất được đặt theo RTO của từng hệ thống và mức độ dữ liệu thay đổi hằng ngày. Dù chọn tần suất nào, mỗi lần thử đều phải ghi lại kết quả để so với RPO và RTO.
Nếu doanh nghiệp đang tự giữ bản sao, chưa thử khôi phục lần nào, hoặc chưa đặt được RPO và RTO, phần vận hành hạ tầng và hỗ trợ kỹ thuật nằm trong nhóm dịch vụ IT của MONA. Gọi 1900 636 648 để trao đổi cách rà lại lịch sao lưu hiện tại.