

Mỗi học sinh nên nhận một thứ tự đáp án riêng, sinh bằng thuật toán Fisher-Yates từ một hạt giống (seed, con số khởi tạo của bộ sinh số ngẫu nhiên) lưu cùng bài làm. Cách đổi chỗ từng đáp án với một vị trí bất kỳ trong cả danh sách trông giống Fisher-Yates nhưng cho kết quả lệch. Với 4 đáp án và đáp án đúng ban đầu ở B, nó đưa đáp án đó về A trong 29,30% số lần và về B trong 22,27% số lần, còn Fisher-Yates cho đúng 25% mỗi vị trí. Hạt giống lưu lại cho phép dựng đúng tờ đề của từng học sinh khi cần chấm lại sau khi giáo viên sửa đáp án.
Mọi đoạn mã và kết quả trong bài chạy trên Python 3.9.6 ngày 29/10/2026. Kết quả dựng bài còn được chạy lại trên Python 3.11.12 và 3.13.14 để so sánh.
Hai cách trộn trông giống nhau nhưng chỉ Fisher-Yates cho kết quả đều
Fisher-Yates đi từ cuối danh sách về đầu và ở mỗi bước đổi chỗ phần tử thứ i với một phần tử ngẫu nhiên trong đoạn từ đầu đến i. Theo Wikipedia, Ronald Fisher và Frank Yates mô tả phương pháp năm 1938 bằng giấy bút, Richard Durstenfeld đưa ra bản dành cho máy tính năm 1964, và Donald Knuth đưa nó vào The Art of Computer Programming. Hàm random.shuffle của Python làm đúng như vậy: mã nguồn bản 3.9 là vòng lặp for i in reversed(range(1, len(x))) với j = randbelow(i + 1).
Bản lệch chỉ khác một chỗ: mỗi lần chọn j trong cả danh sách thay vì trong đoạn đầu đến i. Hai hàm cần so sánh:
def naive_shuffle(a, rng):
    # đổi chỗ từng phần tử với một vị trí bất kỳ trong CẢ mảng
    for i in range(len(a)):
        j = rng.randrange(len(a))
        a[i], a[j] = a[j], a[i]

def fisher_yates(a, rng):
    # đổi chỗ phần tử i với một vị trí trong a[0..i]
    for i in range(len(a) - 1, 0, -1):
        j = rng.randrange(i + 1)
        a[i], a[j] = a[j], a[i]
Hai hàm dài bằng nhau và đều cho ra mọi hoán vị (hoán vị là một thứ tự sắp xếp). Chỗ khác nằm ở số chuỗi lựa chọn j: bản lệch có nn chuỗi mà chỉ có n! hoán vị, và Wikipedia chỉ ra rằng với n lớn hơn 2 con số n! không chia hết nn nên không thể chia đều. Lần chạy đếm trực tiếp mọi chuỗi lựa chọn bằng itertools.product và ghi số lần mỗi hoán vị xuất hiện:
| Số đáp án | Cách trộn | Số chuỗi lựa chọn | Số hoán vị | Hoán vị ít nhất / nhiều nhất xuất hiện |
|---|---|---|---|---|
| 3 | Bản lệch | 27 | 6 | 4 lần / 5 lần |
| 3 | Fisher-Yates | 6 | 6 | 1 lần / 1 lần |
| 4 | Bản lệch | 256 | 24 | 8 lần / 15 lần |
| 4 | Fisher-Yates | 24 | 24 | 1 lần / 1 lần |
Với 4 đáp án, 256 chuỗi chia cho 24 hoán vị được 10,67 chuỗi mỗi hoán vị, nên bản lệch buộc phải cho hoán vị này 8 chuỗi và hoán vị khác 15 chuỗi, chênh gần gấp đôi. Fisher-Yates có đúng 24 chuỗi cho 24 hoán vị.
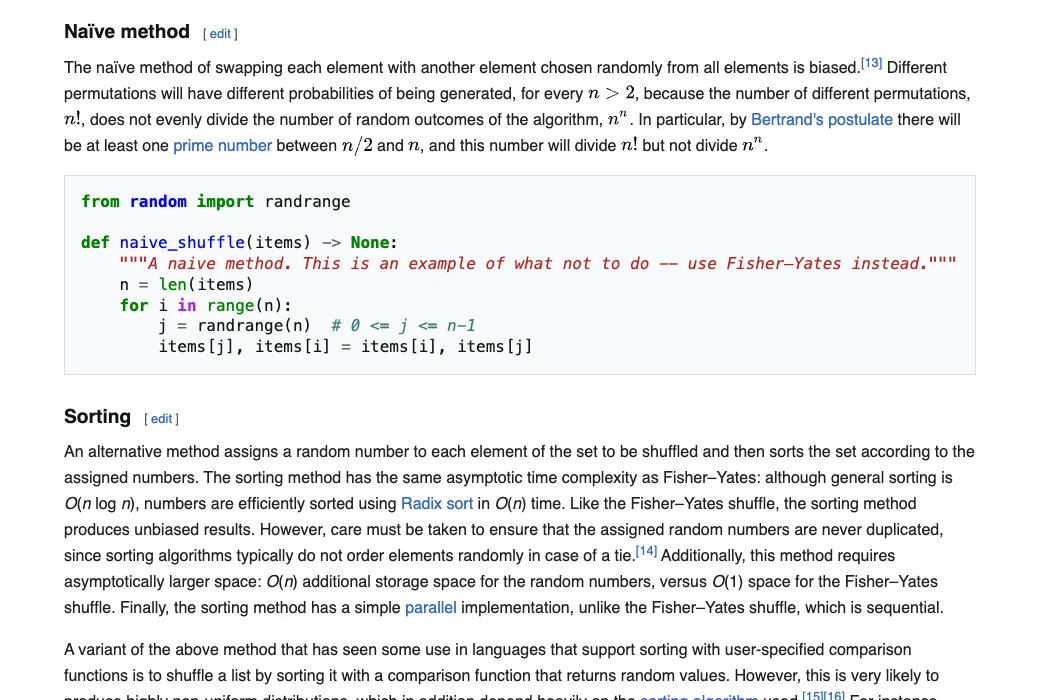
naive_shuffle ở trên, và lý do n! không chia hết nn. Chụp ngày 29/10/2026.Sau 10.000 lần trộn, đáp án đúng chỉ phân bố đều với Fisher-Yates
Điều giáo viên quan tâm là đáp án đúng đứng ở đâu trên tờ đề, chứ không phải hoán vị nào xuất hiện bao nhiêu lần. Thử nghiệm dùng một câu 4 đáp án, đặt đáp án đúng lần lượt ở A, B, C, D, trộn 10.000 lần bằng từng cách (bộ sinh số random.Random(2026)) và đếm vị trí đáp án đúng sau khi trộn. Bảng dưới có thêm thống kê chi-bình-phương, đo độ lệch của số đếm so với phân bố đều 25% mỗi vị trí, trong đó giá trị trên 7,815 (3 bậc tự do) nghĩa là lệch rõ ở mức ý nghĩa 0,05:
| Đáp án đúng ban đầu ở | Cách trộn | Ra A | Ra B | Ra C | Ra D | Chi-bình-phương |
|---|---|---|---|---|---|---|
| A | Bản lệch | 25,90% | 24,61% | 24,27% | 25,22% | 6,2 |
| A | Fisher-Yates | 25,50% | 24,59% | 24,66% | 25,25% | 2,4 |
| B | Bản lệch | 28,82% | 22,73% | 23,74% | 24,71% | 85,7 |
| B | Fisher-Yates | 25,02% | 26,05% | 25,07% | 23,86% | 9,6 |
| C | Bản lệch | 25,80% | 27,58% | 21,68% | 24,94% | 73,3 |
| C | Fisher-Yates | 24,83% | 25,53% | 25,06% | 24,58% | 2,0 |
| D | Bản lệch | 21,01% | 25,00% | 28,80% | 25,19% | 121,6 |
| D | Fisher-Yates | 25,69% | 24,38% | 24,74% | 25,19% | 3,9 |
Bản lệch chỉ đều khi đáp án đúng ban đầu ở A: đếm đủ 256 chuỗi lựa chọn cho đúng 64 chuỗi, tức 25,00%, ở mỗi vị trí. Khi đáp án đúng ban đầu ở B, đếm chính xác cho A 75/256 (29,30%), B 57/256 (22,27%), C 60/256 (23,44%) và D 64/256 (25,00%), khớp với kết quả mô phỏng. Một dòng Fisher-Yates có chi-bình-phương 9,6 cũng vượt ngưỡng, vì ngưỡng 0,05 có nghĩa một bộ dữ liệu đều vẫn bị đánh dấu khoảng 1 lần trong 20. Lặp 200 bộ 10.000 lần trộn với đáp án đúng ở B cho kết quả: bản lệch vượt ngưỡng 200/200 bộ, Fisher-Yates vượt 9/200 bộ (4,5%).
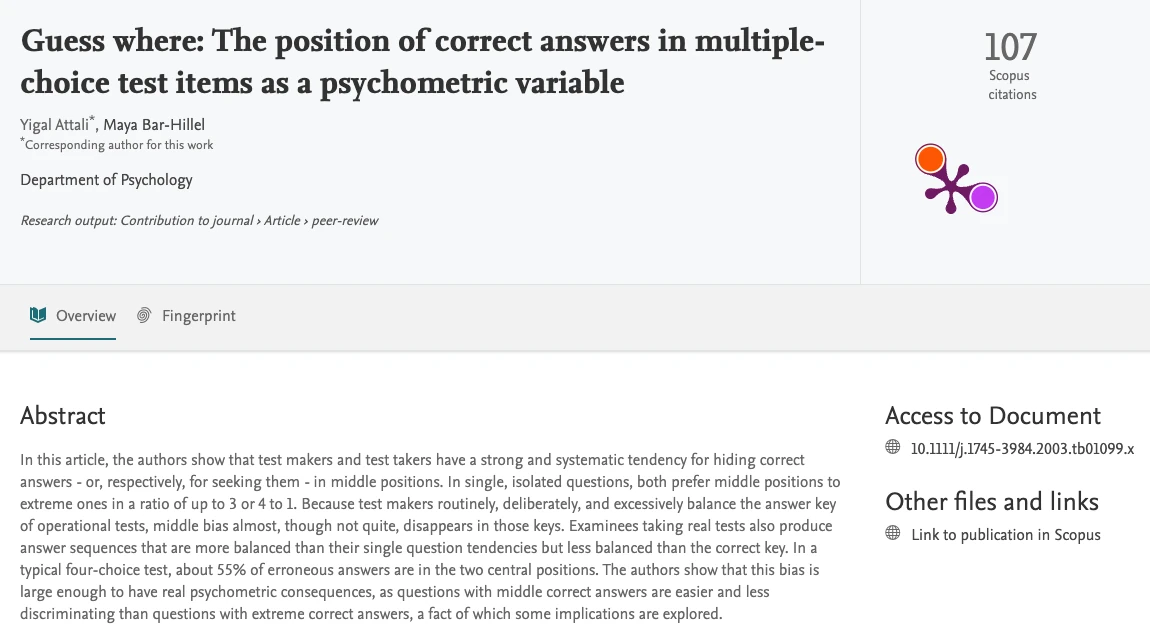
Vị trí ban đầu của đáp án đúng trong ngân hàng câu hỏi hiếm khi đều. Attali và Bar-Hillel (Journal of Educational Measurement, 2003) báo cáo rằng người ra đề và người làm bài cùng có khuynh hướng hệ thống đặt hoặc tìm đáp án đúng ở vị trí giữa. Khi xét từng câu riêng lẻ, vị trí giữa được ưa chuộng hơn vị trí ngoài với tỷ lệ lên tới 3 hoặc 4 trên 1. Trong một đề 4 lựa chọn điển hình, khoảng 55% đáp án sai rơi vào hai vị trí giữa, và câu có đáp án đúng ở giữa dễ hơn, phân loại thí sinh kém hơn câu có đáp án đúng ở hai đầu. Suy ra từ bảng trên (không phải kết luận của bài báo): ngân hàng soạn tay nghiêng về B và C, đúng hai vị trí xuất phát mà bản lệch làm lệch, còn Fisher-Yates xóa dấu vết thói quen của người soạn khỏi tờ đề.
Hạt giống theo từng học sinh và từng câu hỏi dựng lại đúng tờ đề
Trộn không hạt giống cho mỗi học sinh một tờ đề mà hệ thống không dựng lại được, và tải lại trang có thể đổi thứ tự đáp án ngay trước mắt học sinh. Cách sửa là đặt hạt giống từ ba thông tin cố định: mã đề, mã học sinh và mã câu hỏi. Hạt giống là số nguyên 256 bit lấy từ hàm băm Secure Hash Algorithm (SHA-256, đầu ra 256 bit) của chuỗi ghép ba thông tin đó, và mỗi câu có bộ sinh số riêng. Hàm build_paper trộn các đáp án tự do bằng fisher_yates rồi nối các đáp án đã ghim vào cuối (phần ghim giải thích ở mục sau):
def seed_for(exam_id, student_id, question_id):
    h = hashlib.sha256(f"{exam_id}|{student_id}|{question_id}".encode()).digest()
    return int.from_bytes(h, "big")

def build_paper(exam_id, student_id, questions):
    """questions: list of dict(id, options=[(opt_id, text, pinned)])"""
    paper = []
    for q in questions:
        rng = random.Random(seed_for(exam_id, student_id, q["id"]))
        free = [o for o in q["options"] if not o[2]]
        pinned = [o for o in q["options"] if o[2]]
        fisher_yates(free, rng)
        paper.append((q["id"], [o[0] for o in free + pinned]))
    return paper
Chạy với ngân hàng thử 3 câu, mỗi học sinh nhận một thứ tự khác nhau và dựng lại lần hai cho đúng bản đã dựng lần đầu:
hs001 [('q1', ['q1b', 'q1c', 'q1a', 'q1d']), ('q2', ['q2c', 'q2b', 'q2d', 'q2a']), ('q3', ['q3a', 'q3b', 'q3c'])]
hs002 [('q1', ['q1d', 'q1a', 'q1b', 'q1c']), ('q2', ['q2d', 'q2c', 'q2b', 'q2a']), ('q3', ['q3b', 'q3a', 'q3c'])]
dựng lại hs001 lần 2: True
Hạt giống theo từng câu có lý do. Thử với một dòng hạt giống chung cho cả bài (mỗi học sinh một bộ sinh số, các câu trộn nối tiếp nhau) rồi thêm một câu mới vào đầu đề: cả 3 câu cũ đổi thứ tự đáp án. Với hạt giống theo từng câu, thêm câu mới không làm câu cũ nào đổi:
một dòng chung: câu cũ đổi thứ tự sau khi thêm câu mới: ['q1', 'q2', 'q3']
hạt giống theo câu: câu cũ đổi thứ tự: []
Hạt giống chưa phải bảo đảm tuyệt đối. Tài liệu Python nói phần lớn thuật toán và hàm gieo hạt của mô-đun random có thể thay đổi giữa các phiên bản. Tài liệu chỉ bảo đảm hai điều: nếu thêm cách gieo hạt mới thì vẫn có bộ gieo tương thích ngược, và phương thức random() tiếp tục cho cùng một chuỗi với cùng hạt giống. Thuật toán trộn nằm ngoài lời bảo đảm đó. Dấu vân tay SHA-256 của 1.000 tờ đề dựng bằng build_paper giống hệt nhau trên cả 3 bản Python đã chạy (38111acae2e9b2fd ở 16 ký tự đầu), nhưng đó là kết quả quan sát, không phải bảo đảm. Vì vậy hệ thống nên lưu thứ tự đáp án đã hiển thị (danh sách mã đáp án theo từng câu) cùng với hạt giống, và dùng hạt giống làm cách kiểm lại.
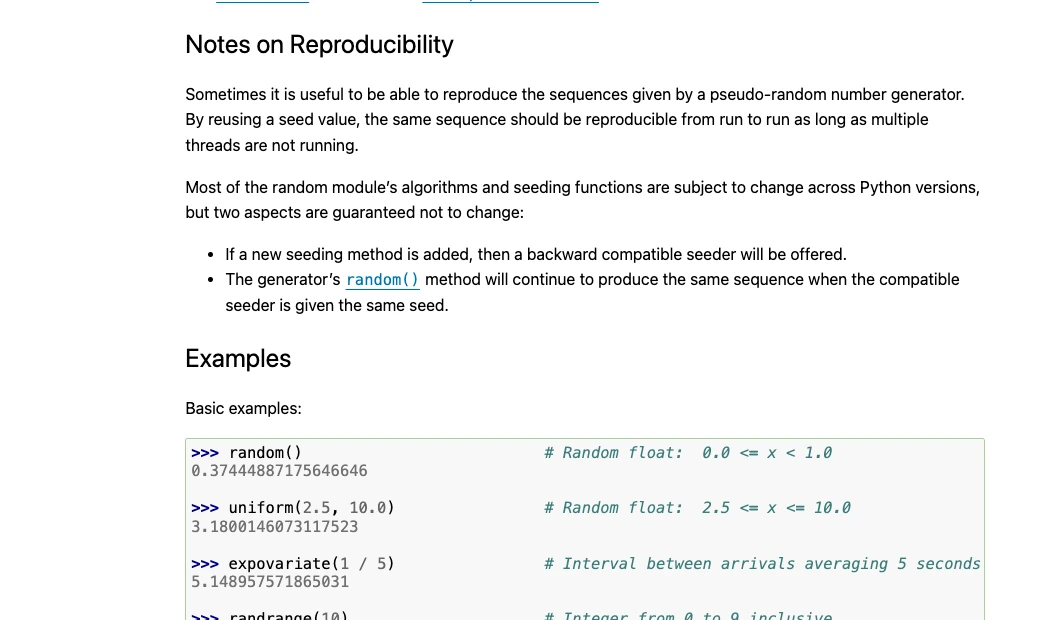
random của Python: hai điều được bảo đảm không đổi giữa các phiên bản. Chụp ngày 29/10/2026.Chấm lại bằng cách dựng tờ đề từ hạt giống, không trộn lại
Giáo viên sửa đáp án đúng của một câu sau khi thi thì hệ thống phải chấm lại mọi bài. Nếu giao diện chỉ lưu chữ cái học sinh thấy trên màn hình (A, B, C hoặc D), hệ thống cần biết chữ cái đó ứng với đáp án nào trên tờ đề của học sinh đó. Ngân hàng thử BANK có 3 câu: q1 và q2 mỗi câu 4 đáp án, q3 có 3 đáp án; KEY ghi mã đáp án đúng của từng câu (q1 là q1b, q2 là q2a, q3 là q3c). Hàm grade dựng lại tờ đề từ hạt giống, đổi chữ cái thành mã đáp án và so với đáp án đúng:
def grade(exam_id, student_id, letters, key):
    paper = build_paper(exam_id, student_id, BANK)
    score = 0
    detail = []
    for (qid, order), letter in zip(paper, letters):
        chosen = order["ABCD".index(letter)]
        ok = chosen == key[qid]
        score += ok
        detail.append((qid, letter, chosen, ok))
    return score, detail
Lần chạy mô phỏng hai học sinh: giao diện lưu chữ cái, đáp án đúng ban đầu của câu q2 là q2a, rồi giáo viên đổi thành q2b. Chấm lại không cần học sinh làm lại và không cần ghi gì thêm:
hs001 đã lưu (chữ cái trên màn hình): ['A', 'B', 'C']
hs002 đã lưu (chữ cái trên màn hình): ['D', 'D', 'C']
hs001 chấm theo đáp án gốc: (2, [('q1', 'A', 'q1b', True), ('q2', 'B', 'q2b', False), ('q3', 'C', 'q3c', True)])
hs002 chấm theo đáp án gốc: (2, [('q1', 'D', 'q1c', False), ('q2', 'D', 'q2a', True), ('q3', 'C', 'q3c', True)])
hs001 chấm lại sau khi sửa đáp án q2: 3
hs002 chấm lại sau khi sửa đáp án q2: 1
Lỗi hay gặp là chấm lại bằng một lần trộn mới. Ba dòng sau (rút gọn từ lần chạy; opts là các đáp án tự do của câu, pinned là đáp án ghim, sc là điểm cộng dồn) thay cho phần dựng tờ đề trong grade:
random.shuffle(opts)
order = opts + pinned
sc += order["ABCD".index(letter)] == KEY[qid]
Chấm bài hs001 tám lần bằng cách đó cho dãy điểm dưới đây, trong khi điểm đúng của bài là 2:
điểm hs001 qua 8 lần chấm lại (đúng là 2): [1, 3, 2, 2, 1, 2, 1, 1]Chỉ 3 trong 8 lần ra đúng 2 điểm, và mỗi lần chạy cho một dãy khác. Nếu học sinh khiếu nại, thứ tự đáp án đã lưu là bằng chứng cho thấy học sinh đã thấy gì trên màn hình. Khi hệ thống lưu mã đáp án học sinh chọn thay cho chữ cái, việc chấm lại không cần hạt giống nữa, và hạt giống chỉ còn dùng để dựng lại tờ đề khi đối chiếu hay khiếu nại. Lưu cả hai là cách đơn giản nhất: mã đáp án để chấm, thứ tự đã hiển thị cùng hạt giống để chứng minh.
Đáp án nhắc đến đáp án khác phải ghim cuối khi trộn
Đáp án kiểu “Cả A và B” hoặc “Tất cả các đáp án trên” chỉ có nghĩa khi đứng sau những đáp án nó nhắc tới. Câu q3 trong ngân hàng thử có 3 đáp án, trong đó q3c là “Cả A và B” và mang cờ pinned bằng True. Chạy 2.000 học sinh, trộn cả 3 đáp án thì q3c đứng đầu danh sách ở 680 tờ (34%), nghĩa là đáp án nhắc tới “A và B” hiện ra trước cả A lẫn B. Với cờ ghim, build_paper giữ q3c ở vị trí cuối của cả 2.000 tờ:
không ghim, đáp án 'Cả A và B' (q3c) đứng đầu: 680 / 2000 bài
có ghim, đứng đầu: 0 / 2000 bài; vị trí cuối: True
Ghim chỉ sửa được thứ tự, còn chữ A và B trong nội dung vẫn là chữ cái ban đầu của ngân hàng, không phải chữ cái hiện trên tờ đề của học sinh sau khi trộn. Cách an toàn là viết lại đáp án thành nội dung (“Cả đáp án x và đáp án y” với x, y chép nguyên văn) hoặc bỏ loại đáp án này khỏi ngân hàng có trộn. Khi chọn phần mềm quản lý ngân hàng câu hỏi, câu cần hỏi là từng đáp án có cờ ghim hay không; danh sách các phần mềm đó nằm ở bài so sánh phần mềm quản lý ngân hàng đề thi.
Hỏi đáp
Dùng thẳng random.shuffle của Python có được không?
random.shuffle của Python có được không?Được cho một danh sách đáp án. Mã nguồn bản 3.9 của random.shuffle là Fisher-Yates như đã dẫn ở trên, và random.Random(seed).shuffle(x) dùng bộ sinh số riêng nên không ảnh hưởng chỗ khác. Tài liệu cảnh báo rằng một dãy dài 2.080 phần tử là lớn nhất mà số hoán vị còn nằm trong chu kỳ của Mersenne Twister, bộ sinh số mặc định của Python, và 4 đáp án hay vài trăm câu hỏi đều nằm xa mức đó. Trong lần chạy, cùng hạt giống cho cùng một tờ đề trên cả 3 bản Python đã thử.
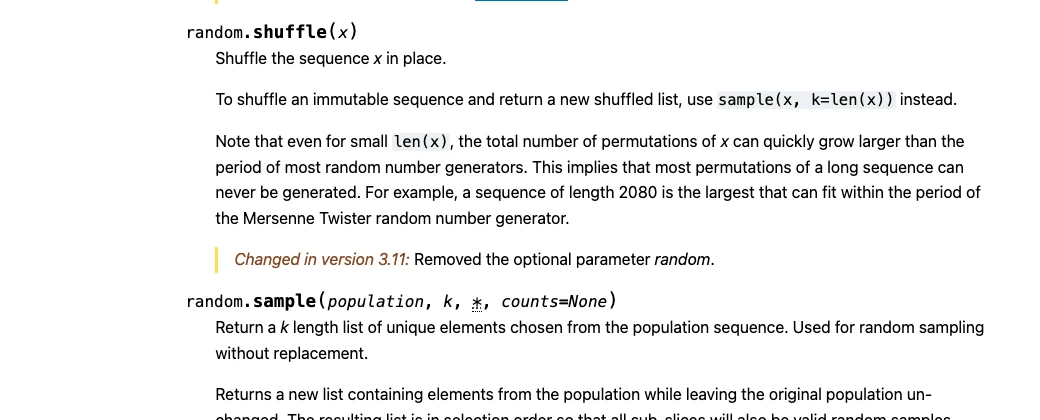
random.shuffle trong tài liệu Python: lưu ý về chu kỳ của bộ sinh số và dãy dài 2.080 phần tử. Chụp ngày 29/10/2026.Hạt giống 32 bit có đủ không?
Không đủ khi trộn thứ tự cả đề. Wikipedia nêu rằng bộ sinh với hạt giống 32 bit chỉ sinh được tối đa 232 hoán vị, và xáo bộ bài 52 lá cần ít nhất 226 bit vì 52! xấp xỉ 2225,6. Lần chạy tính log2(40!) = 159,2 bit cho thứ tự 40 câu, và hạt giống SHA-256 ở trên có 256 bit. Với riêng 4 đáp án của một câu, 24 hoán vị chỉ cần chưa đến 5 bit.
Tải lại trang có đổi thứ tự đáp án không?
Không, vì hạt giống chỉ phụ thuộc mã đề, mã học sinh và mã câu hỏi. Lần chạy dựng hai lần tờ đề của hs001 và so sánh bằng ==, kết quả True. Hai học sinh hs001 và hs002 ở bảng dựng bài nhận thứ tự khác nhau chỉ vì mã học sinh khác nhau. Nếu thêm yếu tố thay đổi như giờ vào hạt giống, tờ đề sẽ đổi mỗi lần tải.
Sắp xếp theo khóa ngẫu nhiên có thay được Fisher-Yates không?
Có điều kiện. Theo Wikipedia, gán mỗi phần tử một số ngẫu nhiên rồi sắp xếp theo số đó cho kết quả không lệch, miễn là các số không trùng nhau, vì thuật toán sắp xếp không xếp ngẫu nhiên các phần tử bằng nhau. Cũng theo trang đó, sắp xếp bằng hàm so sánh trả về giá trị ngẫu nhiên có khả năng cao cho phân bố lệch mạnh; trường hợp này chưa chạy thử.
Đã lưu mã đáp án học sinh chọn thì còn cần hạt giống không?
Chấm lại thì không cần, vì mã đáp án so thẳng với đáp án đúng. Hạt giống vẫn cần khi phải cho học sinh hoặc giáo viên xem lại đúng tờ đề đã hiển thị, và nên lưu kèm thứ tự đã hiển thị vì tài liệu Python chỉ bảo đảm random() ổn định giữa các phiên bản. Hệ thống chỉ lưu chữ cái trên màn hình thì bắt buộc phải có hạt giống, như ở mục chấm lại.
So sánh các phần mềm trộn đề sẵn có ở 10 phần mềm trộn đề trắc nghiệm, phần mềm chấm thi trắc nghiệm và phần mềm thi trắc nghiệm online; chống chuyển tab và gian lận khi thi nằm ở phần mềm chống gian lận thi online. Trung tâm hoặc trường cần hệ thống thi lưu hạt giống và thứ tự đã hiển thị có thể xem MONA LMS (LMS là hệ thống quản lý học tập, xem LMS là gì). MONA cũng xây hệ thống thi theo yêu cầu, hotline 1900 636 648.