

Mỗi tuần lại có một model mới tự nhận vượt bản cao cấp nhất của chính hãng, và doanh nghiệp đang chạy chatbot hay phần mềm có AI khó biết tin nào đổi được hoá đơn của mình. Với DeepSeek V4.1-Flash, câu trả lời ngắn là thế này: DeepSeek ra mắt model này ngày 10/09/2026, giá đầu ra 0,6 USD mỗi triệu token ngoài giờ cao điểm, rẻ hơn V4-Pro từ 3,3 đến 7,3 lần tuỳ loại token. Có hai điểm cần biết trước khi đổi. Giờ cao điểm giá gấp đôi của DeepSeek rơi vào 08:00 đến 11:00 và 13:00 đến 17:00 giờ Việt Nam, tức 7 trên 8 giờ hành chính. Từ 14/09/2026, mọi lệnh gọi tên deepseek-v4-pro cũng đã được hãng chuyển sang V4.1-Flash. Toàn bộ giá và thông số trong bài được MONA tra lại trên trang của DeepSeek ngày 14/10/2026.
DeepSeek công bố gì về V4.1-Flash ngày 10/09/2026
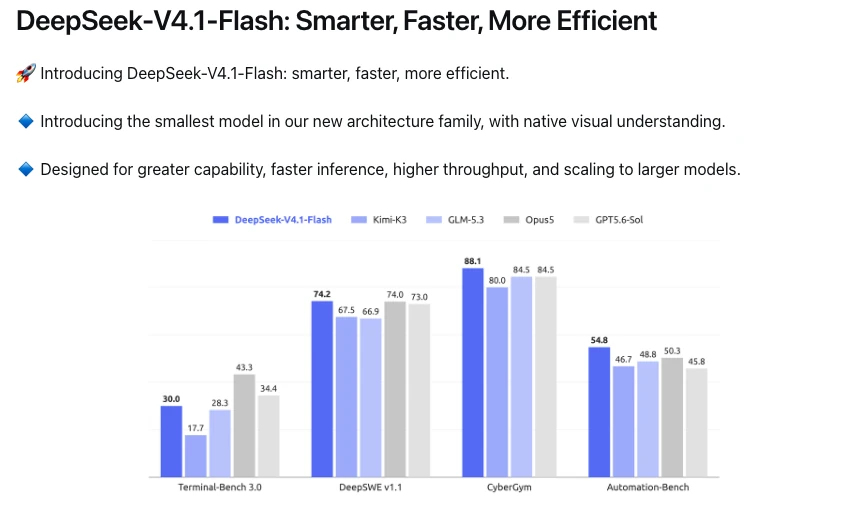
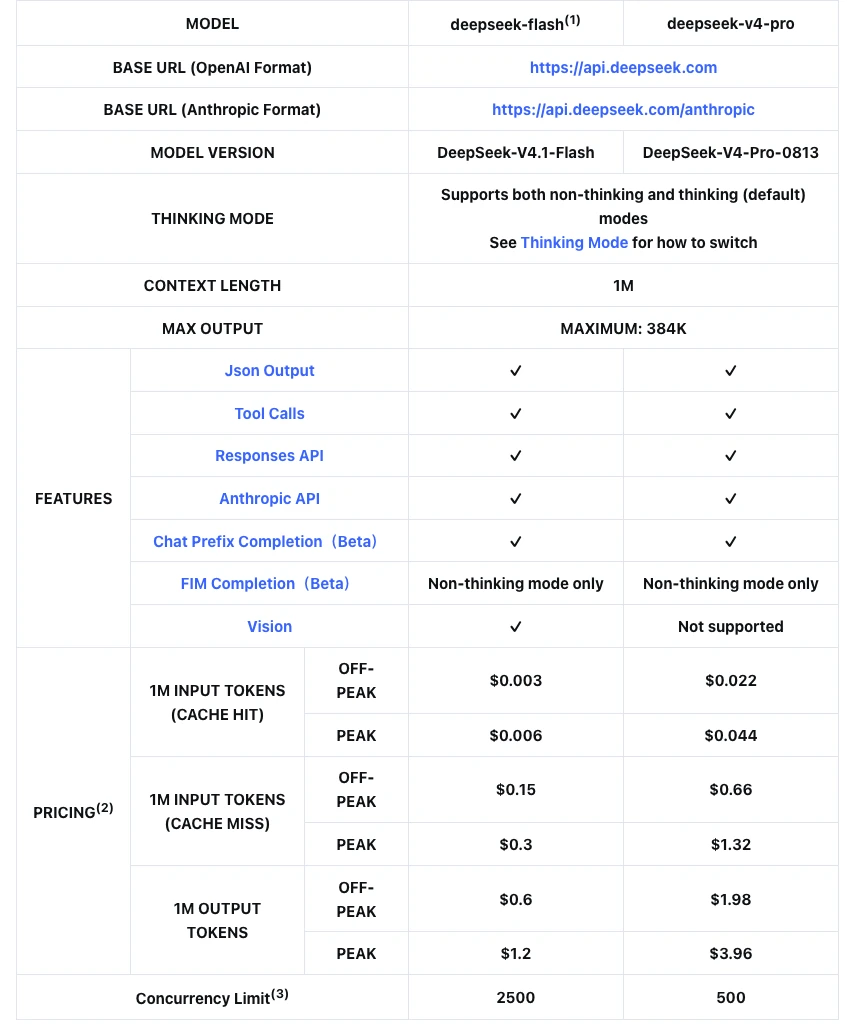
Thông báo nằm trên trang tài liệu API của hãng, mục DeepSeek-V4.1-Flash Release, kèm model card và báo cáo kỹ thuật trên Hugging Face. V4.1-Flash là model nhỏ nhất của dòng kiến trúc mới, tổng cộng 552 tỷ tham số theo kiểu Mixture-of-Experts, nhưng mỗi token chỉ kích hoạt 8 tỷ tham số khi đọc đầu vào và 16 tỷ khi sinh đầu ra. Cửa sổ ngữ cảnh là 1 triệu token, câu trả lời dài tối đa 384.000 token, và model đọc được ảnh ngay từ đầu chứ không cần bản vision riêng. Hãng viết rằng kết quả benchmark của V4.1-Flash đứng trên các model chủ lực, kể cả DeepSeek-V4-Pro, và rằng nhiều bên thử nghiệm đã xếp nó trên V4-Pro về hiệu năng, chi phí, tốc độ và tổng thời gian chạy.
Phần kiến trúc giải thích vì sao giá giảm được. Model card ghi bộ nhớ đệm KV của V4.1-Flash chỉ còn 890 byte mỗi token, khoảng một phần tư so với V4-Flash, và phần phải lưu xuống ổ SSD còn khoảng một phần tám. Với các tác vụ agent đọc đi đọc lại một ngữ cảnh dài, tiền trả cho token trúng cache chiếm phần lớn hoá đơn. Nén cache vì thế là cách hãng hạ giá mà vẫn có lãi. Trọng số model được phát hành theo giấy phép MIT trên trang Hugging Face của DeepSeek, nghĩa là doanh nghiệp có hạ tầng GPU đủ lớn có thể tự chạy model trong máy chủ của mình. Một model 552 tỷ tham số vẫn cần cụm GPU cỡ trung tâm dữ liệu, vì vậy với phần đông doanh nghiệp Việt, con đường thực tế vẫn là gọi qua API.
V4.1-Flash rẻ hơn V4-Pro bao nhiêu theo bảng giá chính thức
Thông báo không ghi V4.1-Flash rẻ hơn bao nhiêu lần, MONA đặt hai cột giá trên trang Models & Pricing cạnh nhau rồi tự chia. Tính ở cùng một khung giờ, đầu ra rẻ hơn 3,3 lần, đầu vào chưa trúng cache rẻ hơn 4,4 lần, đầu vào đã trúng cache rẻ hơn 7,3 lần. Bảng giá tra ngày 14/10/2026 vẫn đúng với số hãng công bố ngày 10/09/2026, chưa có điều chỉnh nào.
| Giá mỗi 1 triệu token (USD) | V4.1-Flash ngoài cao điểm | V4.1-Flash cao điểm | V4-Pro ngoài cao điểm | V4-Pro cao điểm | Flash rẻ hơn |
|---|---|---|---|---|---|
| Đầu vào trúng cache | 0,003 | 0,006 | 0,022 | 0,044 | 7,3 lần |
| Đầu vào chưa trúng cache | 0,15 | 0,3 | 0,66 | 1,32 | 4,4 lần |
| Đầu ra | 0,6 | 1,2 | 1,98 | 3,96 | 3,3 lần |
| Số lệnh gọi đồng thời tối đa | 2.500 | 500 | Gấp 5 lần | ||
Dòng cuối ít ai để ý mà lại quan trọng với hệ thống chạy thật. Giới hạn 2.500 lệnh gọi cùng lúc của V4.1-Flash gấp năm lần V4-Pro, nên một chatbot trả lời nhiều khách cùng lúc, hay một job xử lý hàng nghìn hồ sơ song song, ít bị hãng chặn vì vượt hạn mức hơn. Về tốc độ thì hãng không đưa con số nào. Thông báo chỉ viết V4.1-Flash nhanh hơn V4-Pro, không kèm số token mỗi giây hay thời gian chờ tới chữ đầu tiên, và khi gọi từ máy chủ đặt ở Việt Nam thì thời gian chờ còn cộng thêm đoạn đường mạng tới máy chủ của hãng.
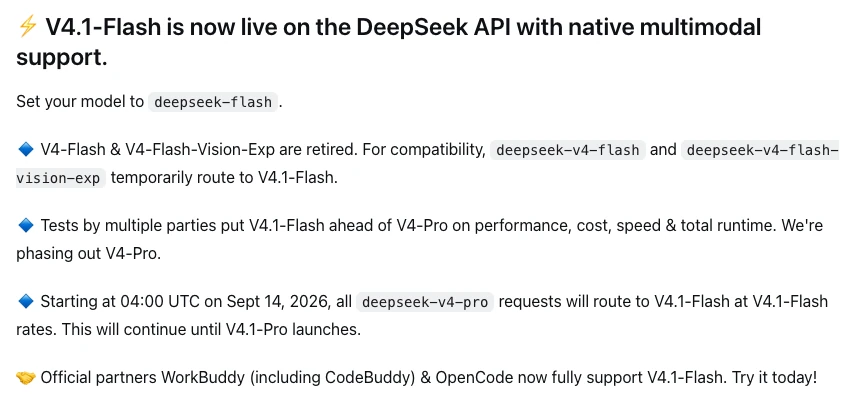
Có một chỗ bảng giá và thông báo chưa khớp nhau. Bảng giá vẫn để cột V4-Pro với mức giá riêng, còn thông báo ngày 10/09/2026 ghi rằng từ 04:00 UTC ngày 14/09/2026, mọi lệnh gọi deepseek-v4-pro sẽ được chuyển sang V4.1-Flash và tính theo giá V4.1-Flash, cho tới khi V4.1-Pro ra mắt. Hãng cũng nói thẳng đang cho V4-Pro nghỉ hưu. Doanh nghiệp đang trả tiền V4-Pro nên mở hoá đơn tháng 9 và tháng 10 ra xem đơn giá thật đã đổi chưa, vì thứ đang trả lời khách của mình có thể đã là một model khác.
Giờ cao điểm của DeepSeek trùng giờ hành chính ở Việt Nam
Chú thích dưới bảng giá ghi giờ cao điểm là 01:00 đến 04:00 và 06:00 đến 10:00 giờ UTC, từ thứ Hai tới thứ Sáu, trừ ngày lễ của Trung Quốc. Đổi sang giờ Việt Nam là 08:00 đến 11:00 và 13:00 đến 17:00. Một văn phòng làm từ 8 giờ sáng tới 5 giờ chiều, nghỉ trưa một tiếng, có 8 giờ làm việc thì 7 giờ rơi vào khung giá gấp đôi, chỉ còn 11:00 đến 12:00 là được giá thường. Cuối tuần và ngày lễ Trung Quốc thì cả ngày được tính giá ngoài cao điểm, còn ngày lễ của Việt Nam không có trong danh sách này.
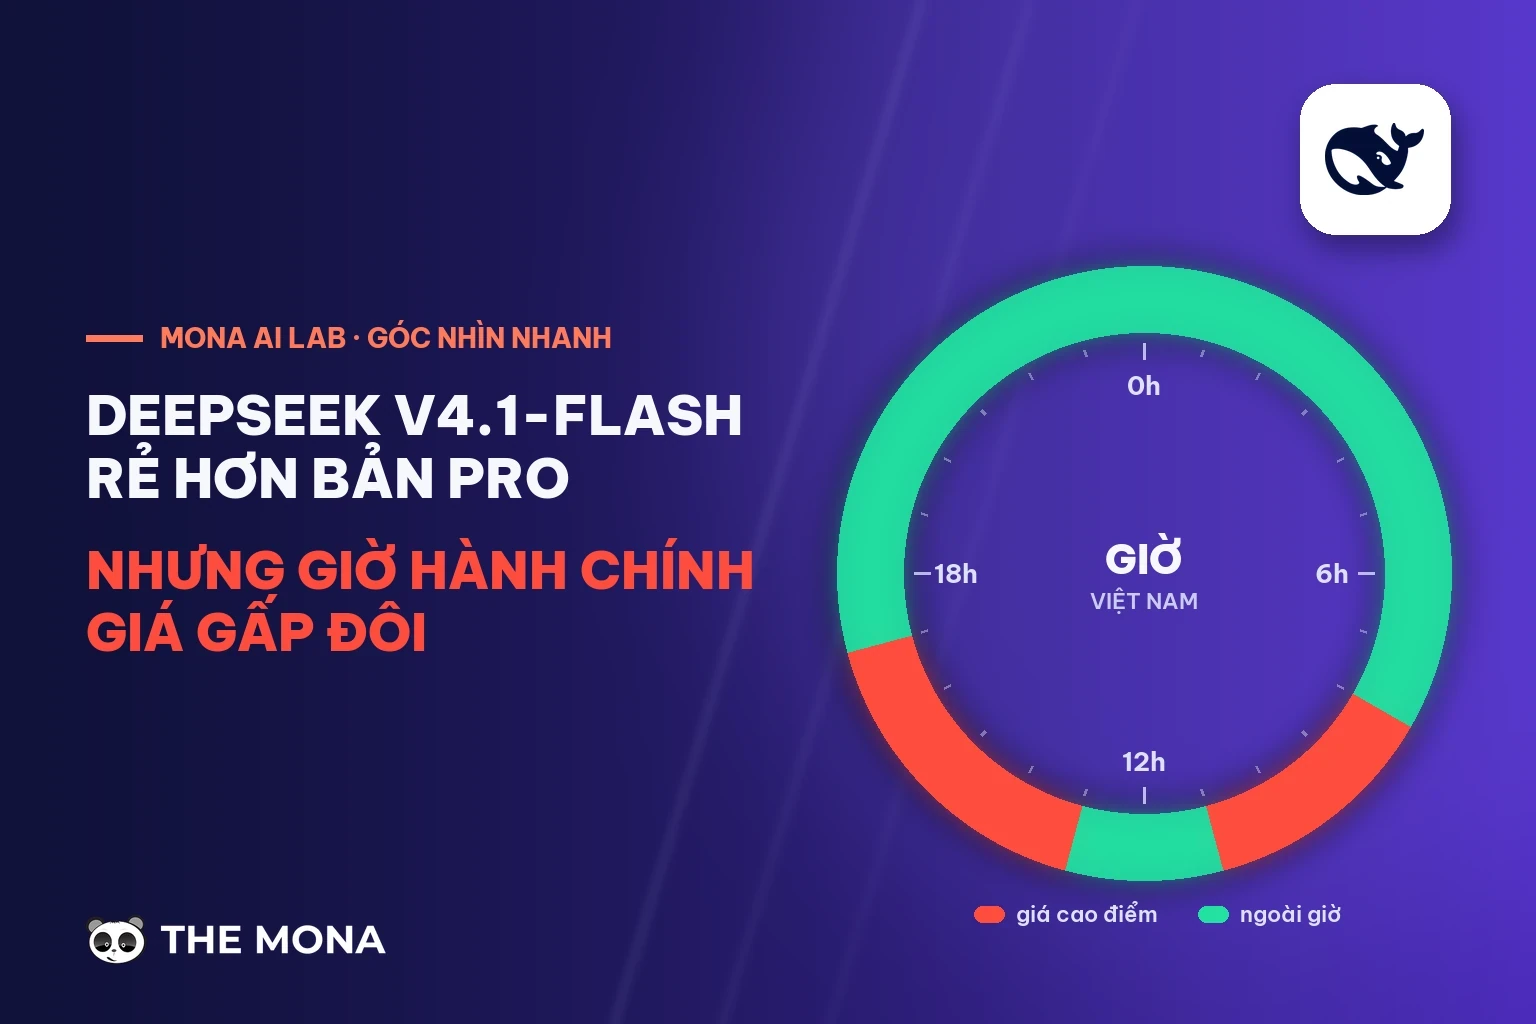
Chatbot và tổng đài trả lời khách là loại việc chịu thiệt nhất, vì khách nhắn và gọi đông nhất đúng mấy khung giờ đó. Khi tính chi phí cho một chatbot chạy giữa ngày ở Việt Nam, MONA lấy giá cao điểm làm mặc định, còn giá rẻ chỉ áp cho phần việc dời được. Loại việc dời được là việc chạy theo lô: tóm tắt cuộc gọi trong ngày, phân loại lead, soạn nháp email trả lời, trích thông tin từ hoá đơn hay hợp đồng. Đẩy những job này sang sau 17:00, giờ nghỉ trưa hoặc cuối tuần là trả đúng một nửa giá, mà khách hàng không thấy khác gì.
Chi phí 1.000 lượt chatbot tính bằng tiền Việt
Để quy ra tiền, MONA lấy một lượt chatbot giả định gồm 6.000 token hướng dẫn và chính sách cố định đã trúng cache, 400 token câu hỏi mới của khách và 250 token câu trả lời. Tỷ giá dùng là giá bán ra của Vietcombank ngày 14/10/2026, 26.080 đồng mỗi USD. Một lượt như vậy trên V4.1-Flash ngoài cao điểm tốn 0,000228 USD, phần lớn là tiền đầu ra.
| Model và khung giờ | Chi phí 1.000 lượt | Chi phí 100.000 lượt |
|---|---|---|
| V4.1-Flash, ngoài giờ cao điểm | 5.946 đồng | khoảng 595.000 đồng |
| V4.1-Flash, giờ cao điểm | 11.892 đồng | khoảng 1,19 triệu đồng |
| V4-Pro, ngoài giờ cao điểm | 23.237 đồng | khoảng 2,32 triệu đồng |
| V4-Pro, giờ cao điểm | 46.475 đồng | khoảng 4,65 triệu đồng |
Ở cùng khung giờ, V4-Pro đắt gần gấp bốn lần V4.1-Flash. Con số đáng nhìn kỹ hơn là khoảng cách giữa hai dòng đầu: cùng một model, cùng một khối lượng câu hỏi, chạy giữa ngày tốn gấp đôi chạy buổi tối. Đây vẫn là phép tính trên giả định. Hoá đơn thật sẽ lệch theo độ dài câu trả lời model tự sinh, nhất là khi bật chế độ suy nghĩ (thinking mode, mặc định của V4.1-Flash), vì phần suy nghĩ cũng tính là token đầu ra. Bài tính chi phí cho chatbot nên chạy thử vài trăm hội thoại thật rồi đọc lại số token đầu ra trung bình, thay vì tin con số 250 token như trên.
Tên model cũ đã được chuyển sang V4.1-Flash mà không báo lỗi
Chi tiết này ảnh hưởng thẳng tới phần mềm đang chạy. Thông báo ghi V4-Flash và V4-Flash-Vision-Exp đã nghỉ hưu, còn hai tên deepseek-v4-flash và deepseek-v4-flash-vision-exp được chuyển tạm sang V4.1-Flash để không làm gãy hệ thống cũ. Chú thích trên bảng giá ngày 14/10/2026 nói rõ hơn: hai tên cũ vẫn được chấp nhận, nhưng yêu cầu gửi tới sẽ do V4.1-Flash xử lý và tính theo giá Flash. Tên mới hãng khuyên dùng là deepseek-flash.
Phần mềm gọi tên cũ vẫn chạy, không nhận được mã lỗi nào, nhưng model trả lời đã khác. Một chatbot đã được tinh chỉnh câu lệnh hệ thống cho V4-Flash có thể đổi giọng, đổi độ dài câu trả lời, hoặc gọi công cụ theo cách khác mà không ai trong công ty biết lý do. Đội kỹ thuật nên làm lần lượt mấy việc sau:
- Tìm trong mã nguồn và file cấu hình mọi chỗ gọi deepseek-v4-flash, deepseek-v4-flash-vision-exp và deepseek-v4-pro.
- Đổi sang tên deepseek-flash và ghi lại ngày đổi, để sau này đọc log còn biết từ lúc nào model đã khác.
- Chạy lại bộ câu hỏi kiểm thử của chatbot hoặc AI Agent, so câu trả lời với bản trước ngày 10/09/2026.
- Đối chiếu hoá đơn tháng 9 và tháng 10 theo từng khung giờ, tách phần token trúng cache ra riêng.
- Dời các job chạy theo lô sang sau 17:00 giờ Việt Nam hoặc cuối tuần để hưởng giá ngoài cao điểm.
Chuyện tên model bị chuyển âm thầm không riêng gì DeepSeek. Hãng nào cũng có lúc cho model cũ nghỉ hưu, nên phần mềm có AI cần ghi tên model thật vào log mỗi lần gọi và có bộ kiểm thử chạy lại được. Bài MCP server là gì và cách cho AI Agent dùng phần mềm nội bộ an toàn nói thêm về lớp ghi log và phân quyền khi model được chạm vào dữ liệu thật.
Bảng điểm của hãng chưa nói gì về tiếng Việt
Phần lớn bảng điểm trên model card là lập trình, toán và tác vụ agent, và toàn bộ do DeepSeek tự chạy. Ở bài đo lập trình DeepSWE v1.1, V4.1-Flash đạt 74,2 điểm, Claude Opus 5 đạt 74,0 và GPT-5.6 Sol đạt 73,0, ba model cách nhau chưa tới 1,2 điểm. Ở các bài đo agent khó hơn như Terminal-Bench phiên bản 4, V4.1-Flash đạt 31,2 điểm trong khi Opus 5 đạt 51,8. Mỗi model mạnh ở một kiểu việc, và hãng chọn bốn bài đo đẹp nhất để đặt lên đầu thông báo.
Với doanh nghiệp Việt chạy chatbot hay xử lý văn bản tiếng Việt, mấy dòng ở bảng model gốc (base model) đáng đọc hơn. Bài đo đa ngôn ngữ MultiLoKo cho V4.1-Flash 45,5 điểm, thấp hơn V4-Pro ở mức 50,9. Bài toán đố đa ngôn ngữ MGSM cho V4.1-Flash 80,2, thấp hơn cả V4-Flash đời trước ở mức 85,7. Bài kiểm kiến thức SimpleQA-Verified cho 42,3 so với 55,2 của V4-Pro, và bài đọc văn bản dài LongBench-V2 cho 45,2 so với 51,5. Nghĩa là ở đúng những việc gần với chatbot tiếng Việt nhất, gồm hiểu ngôn ngữ khác tiếng Anh, nhớ đúng sự thật và đọc tài liệu dài, bản Flash vẫn đứng sau bản Pro. Bảng điểm cũng không có dòng nào đo riêng tiếng Việt, nên chưa biết model đọc số tiền, địa chỉ hay tên riêng người Việt tốt tới đâu.
Nên dùng V4.1-Flash cho việc gì trong phần mềm doanh nghiệp
Từ bảng giá và bảng điểm, MONA chia việc thành ba nhóm. Nhóm hợp nhất là việc chạy theo lô ngoài giờ cao điểm và việc đọc tài liệu rất dài: tóm tắt cuộc gọi cuối ngày, phân loại lead từ form và tin nhắn, trích dữ liệu từ hoá đơn, soạn nháp tài liệu cần đọc hàng trăm nghìn token ngữ cảnh. Ở nhóm này, mức giá 0,6 USD mỗi triệu token đầu ra, cửa sổ 1 triệu token và giới hạn 2.500 lệnh gọi đồng thời cộng lại thành một lựa chọn rẻ khó tìm. Nhóm thứ hai là AI Agent làm việc với code hay công cụ nội bộ, nơi điểm DeepSWE và Terminal-Bench 2.1 của V4.1-Flash ngang các model đắt hơn nhiều lần. Bài AI Agent là gì và doanh nghiệp nên giao việc nào cho AI Agent có năm tiêu chí để chọn việc cho agent.
Nhóm cần thận trọng là chatbot trả lời khách trực tiếp bằng tiếng Việt giữa ngày. Ở đây doanh nghiệp vừa trả giá cao điểm, vừa dùng model có điểm đa ngôn ngữ thấp hơn bản Pro, trong khi chưa có số đo nào trên hội thoại tiếng Việt thật. Nếu chatbot hiện tại đang chạy ổn trên một model khác, chưa có lý do để đổi chỉ vì bảng giá. Với chatbot chăm sóc khách hàng đa kênh, cách hợp lý là cho V4.1-Flash chạy song song ở phần việc phía sau, ví dụ tóm tắt và gắn nhãn hội thoại, rồi so chất lượng trong vài tuần trước khi giao nó trả lời khách. Doanh nghiệp đang cân nhắc chạy model trong máy chủ riêng vì chuyện dữ liệu có thể đọc thêm nghiên cứu AI local hay tài khoản AI cho doanh nghiệp, vì trọng số MIT của V4.1-Flash mở ra đúng lựa chọn đó.
Cùng đợt này, MONA cũng đã viết về hai thay đổi giá của các hãng khác: Gemini 3.8 Flash và mức giá mới của Google, và GPT-6 Astra cùng bảng giá của OpenAI. Đặt ba bài cạnh nhau sẽ thấy giá mỗi triệu token giờ đổi theo giờ trong ngày, theo độ dài ngữ cảnh và theo tên model đang gọi, và một con số trên trang giá chưa đủ để tính hoá đơn.
Hỏi đáp
DeepSeek V4.1-Flash ra mắt khi nào?
DeepSeek công bố V4.1-Flash ngày 10/09/2026 trên trang tài liệu API, bảng giá mới có hiệu lực từ 04:00 UTC cùng ngày, tức 11:00 giờ Việt Nam. Model card và báo cáo kỹ thuật được đăng cùng lúc trên Hugging Face.
V4.1-Flash rẻ hơn V4-Pro bao nhiêu lần?
Theo bảng giá tra ngày 14/10/2026, ở cùng khung giờ, đầu ra rẻ hơn 3,3 lần (0,6 so với 1,98 USD mỗi triệu token), đầu vào chưa trúng cache rẻ hơn 4,4 lần và đầu vào đã trúng cache rẻ hơn 7,3 lần. Với lượt chatbot giả định trong bài, V4-Pro đắt gần gấp bốn lần.
Giờ cao điểm của DeepSeek là mấy giờ ở Việt Nam?
Từ 08:00 đến 11:00 và từ 13:00 đến 17:00 giờ Việt Nam, thứ Hai tới thứ Sáu, trừ ngày lễ Trung Quốc. Trong khung này giá gấp đôi. Cuối tuần và ngày lễ Trung Quốc được tính giá ngoài cao điểm cả ngày.
Hệ thống đang gọi deepseek-v4-flash hoặc deepseek-v4-pro có bị lỗi không?
Không báo lỗi. Hai tên cũ vẫn được chấp nhận, nhưng yêu cầu đã do V4.1-Flash xử lý và tính theo giá Flash, với deepseek-v4-pro là từ 04:00 UTC ngày 14/09/2026. Cách xử lý là đổi sang tên deepseek-flash và chạy lại bộ kiểm thử để biết câu trả lời đã khác thế nào.
V4.1-Flash có tốt cho chatbot tiếng Việt không?
Chưa có số đo công khai nào cho tiếng Việt. Ở bảng model gốc, điểm đa ngôn ngữ MultiLoKo của V4.1-Flash là 45,5, thấp hơn V4-Pro ở mức 50,9. Muốn biết chắc thì phải chạy thử trên hội thoại tiếng Việt thật của chính doanh nghiệp, đo chất lượng câu trả lời và thời gian chờ khi gọi từ Việt Nam.
Chọn model cho phần mềm doanh nghiệp giờ phải tính cả giá theo giờ, loại việc và lịch hãng đổi tên model, bên cạnh bảng điểm. MONA viết AI Agent theo yêu cầu và chatbot AI cho doanh nghiệp với lớp chọn model tách riêng, ghi log tên model thật mỗi lần gọi và lịch chạy job theo khung giờ rẻ, để khi hãng đổi giá hay cho model nghỉ hưu, doanh nghiệp chỉ cần đổi cấu hình. Cần tính lại chi phí AI cho hệ thống đang chạy, gọi MONA qua hotline 1900 636 648.