

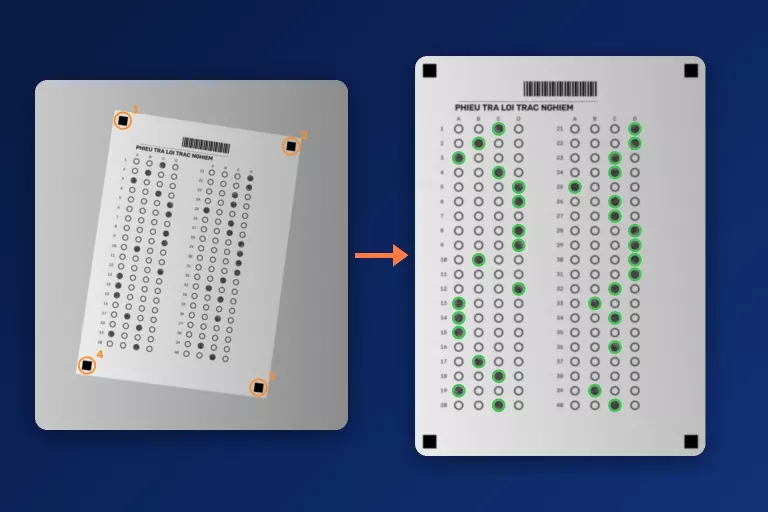
Đọc phiếu trắc nghiệm từ ảnh chụp cần năm bước OpenCV: chuyển xám, nhị phân hóa, nắn phiếu theo bốn ô vuông ở góc, đo tỷ lệ mực trong từng ô tròn, rồi quyết định ô nào đã tô. Trên 200 phiếu giả lập cho mỗi điều kiện, bộ đọc B (dùng ngưỡng cục bộ, mô tả bên dưới) đọc đúng 100% số câu khi phiếu xoay tới 30 độ, mờ Gaussian với độ lệch chuẩn 5 điểm ảnh, hoặc mép phải tối hơn mép trái 34%. Ba điều kiện làm hỏng cả ba bộ đọc thử trong bài (A, B và D): nét chì xám 210 trên nền giấy 245, vết tẩy còn một nửa chì, và phiếu úp ngược. Mọi phiếu trong bài do script Python 3.9 với OpenCV 5.0.0 vẽ ra, là phiếu giả lập chứ không phải ảnh quét thật. Số đo cho biết bộ đọc phản ứng ra sao khi một yếu tố đổi, và không thay cho phép thử trên phiếu thật của trường.
Một con số 99% cho mỗi câu vẫn để 21% số phiếu có ít nhất một câu sai khi phiếu có 40 câu: ở nét chì xám 180, bộ đọc B đọc đúng 99,41% số câu và chỉ 158 trên 200 phiếu đúng cả 40 câu. Phần đo theo ô, theo câu và theo phiếu nằm ở mục “Đo độ chính xác theo ô, theo câu và theo phiếu”.
Phiếu thử: 40 câu, bốn đáp án, vẽ bằng script rồi giả lập ảnh chụp
Phiếu chuẩn rộng 800 và cao 1100 điểm ảnh, gồm hai khối 20 hàng, mỗi hàng bốn ô tròn A đến D bán kính 11 điểm ảnh, vòng viền in xám 70 dày 2 điểm ảnh. Bốn ô vuông đen cạnh 36 điểm ảnh nằm ở bốn góc, cách mép 40 điểm ảnh. Một dãy vạch giống mã vạch và dòng tiêu đề chữ đen đóng vai vật gây nhiễu, vì bộ tìm ô vuông phải bỏ qua chúng. Mỗi câu có 5% xác suất bỏ trống, còn lại một đáp án ngẫu nhiên; nét tô là một đĩa xám có nhiễu Gaussian độ lệch chuẩn 12 mức xám, và 12% điểm ảnh để trống như hạt giấy.
Từ phiếu chuẩn, script dựng ảnh chụp theo thứ tự: đặt phiếu lên bàn xám 200 trong khung 1300×1450, xoay hoặc làm lệch phối cảnh, nhân một trường sáng, làm mờ Gaussian, cộng nhiễu Gaussian độ lệch chuẩn 3 mức xám, rồi nén JPEG (định dạng ảnh nén có mất dữ liệu) khi điều kiện yêu cầu. Bảng dưới liệt kê các điều kiện đã đo, mỗi điều kiện 200 phiếu với hạt giống ngẫu nhiên 0 đến 199. Mỗi dòng đo 8.000 câu, trừ dòng nghiêng 60 điểm ảnh có phiếu bị từ chối:
| Điều kiện | Các mức đã thử |
|---|---|
| Xoay phiếu | 3°, 10°, 30°, 180° |
| Nghiêng góc máy | mỗi góc phiếu lệch ngẫu nhiên tối đa 20 hoặc 60 điểm ảnh |
| Mờ | Gaussian 1,5; 3; 5 điểm ảnh |
| Sáng lệch | mép phải còn 80%, 66%, 50% độ sáng của mép trái |
| Bóng đổ | nửa phiếu nằm trong bóng, còn 50% độ sáng |
| Chì nhạt | mức xám 100, 140, 180, 210 (giấy 245, chì chuẩn 40) |
| Gạch chéo thay vì tô kín | một nét rộng 3,5 điểm ảnh trên 30% số câu; thêm phép quét độ rộng nét từ 1,5 đến 5 |
| Tẩy | 20% số câu có một đáp án cũ bị tẩy, chì còn lại 12%, 25% hoặc 50% |
| Tô hai ô | 10% số câu; ô thứ hai đậm như ô đầu hoặc xám 150 |
| JPEG | chất lượng 20 |
| Kết hợp | xoay 5°, nghiêng 15, mờ 1,5, mép phải còn 73% độ sáng, chì xám 140, JPEG 40 |
Mã dựng phiếu không đăng trong bài. Các hàm đọc phiếu bên dưới được in nguyên văn từ file đã chạy. Ngưỡng của bộ đọc B và D chọn trên các hạt giống 5000 trở lên (15 đến 20 phiếu mỗi điều kiện), tách khỏi 200 phiếu đo.
Từ ảnh chụp đến đáp án: chuyển xám, nhị phân hóa, nắn lưới, đo mức tô, quyết định
Thứ tự các bước quyết định ngưỡng nào còn dùng được, và bài đi theo đúng thứ tự mã chạy:
- Chuyển ảnh về xám và làm mờ Gaussian 5×5 để triệt nhiễu hạt. Phiếu giả lập đã là ảnh xám; ảnh chụp màu cần thêm cv2.cvtColor(img, cv2.COLOR_BGR2GRAY), bước này chưa chạy trong bài.
- Nhị phân hóa ảnh để tách mực khỏi giấy, bằng ngưỡng toàn ảnh do thuật toán Otsu chọn từ histogram, hoặc ngưỡng cục bộ (cv2.adaptiveThreshold).
- Tìm bốn ô vuông ở góc bằng cv2.findContours, rồi nắn phiếu về khung 800×1100 bằng cv2.getPerspectiveTransform và cv2.warpPerspective.
- Lấy một đĩa bán kính 7 điểm ảnh (0,65 lần bán kính ô) ở tâm mỗi ô tròn và đo tỷ lệ điểm ảnh là mực. Đĩa nhỏ hơn ô để vòng in ở bán kính 10 đến 12 không lọt vào phép đo.
- Gộp bốn số của mỗi hàng thành một kết quả: – là bỏ trống, một chữ cái là một ô tô, * là tô nhiều hơn một ô.
Hằng số bố cục và hàm bubble_xy cho tâm của 160 ô. Mọi bước sau tra tâm ô từ đây, tức bộ đọc biết trước vị trí từng ô và không tự dò vòng tròn:
W, H = 800, 1100            # canonical sheet, pixels
MK = 36                     # marker side
MARKERS = np.float32([[40, 40], [W - 40, 40], [W - 40, H - 40], [40, H - 40]])  # tl,tr,br,bl centres
R = 11                      # bubble radius
NQ, NOPT = 40, 4
BLOCK_X = (120, 440)        # x of the first option column in each block
OPT_DX, ROW_Y0, ROW_DY = 55, 200, 40
LETTERS = "ABCD"

def bubble_xy(q):
    blk, row = divmod(q, 20)
    return [(BLOCK_X[blk] + j * OPT_DX, ROW_Y0 + row * ROW_DY) for j in range(NOPT)]
Hàm read_sheet nối các bước lại. Ba bộ đọc chính A, B và D khác nhau ở bước nhị phân hóa và bước quyết định, được khai báo trong từ điển READERS; hai mục sau giải thích từng tham số. B41 là B với cửa sổ 41 điểm ảnh, dùng ở mục nhị phân hóa, và B0 là B bỏ quy tắc so với ô đậm nhất cùng hàng, dùng ở mục quyết định:
READERS = {
    "A": dict(mode="otsu", t_abs=0.5, t_rel=0.0),        # một ngưỡng Otsu cho cả phiếu, ô tô khi từ 50% điểm ảnh là mực
    "B": dict(mode="adaptive", C=25, block=101, t_abs=0.3, t_rel=0.8),  # ngưỡng cục bộ, cộng quy tắc so với ô đậm nhất cùng hàng
    "B0": dict(mode="adaptive", C=25, block=101, t_abs=0.3, t_rel=0.0),  # B bỏ quy tắc tương đối
    "D": dict(mode="dark", t_abs=55, t_rel=0.45),                      # điểm tối = mức giấy trừ xám trung bình, không nhị phân hóa
    "B41": dict(mode="adaptive", C=25, block=41, t_abs=0.3, t_rel=0.8),  # B với cửa sổ 41 điểm ảnh
}

def read_sheet(photo, reader, cache=None):
    pts = find_markers(photo)
    if pts is None:
        return None
    M = cv2.getPerspectiveTransform(pts, MARKERS)
    warped = cv2.warpPerspective(photo, M, (W, H))
    cfg = dict(READERS[reader])
    key = (cfg["mode"], cfg.get("C", 30), cfg.get("block", 101))
    if cache is not None and key in cache:       # các bộ đọc cùng ngưỡng dùng chung kết quả
        ratios = cache[key]
    else:
        ratios = fill_ratios(warped, *key)
        if cache is not None:
            cache[key] = ratios
    return decide(ratios, cfg["t_abs"], cfg["t_rel"])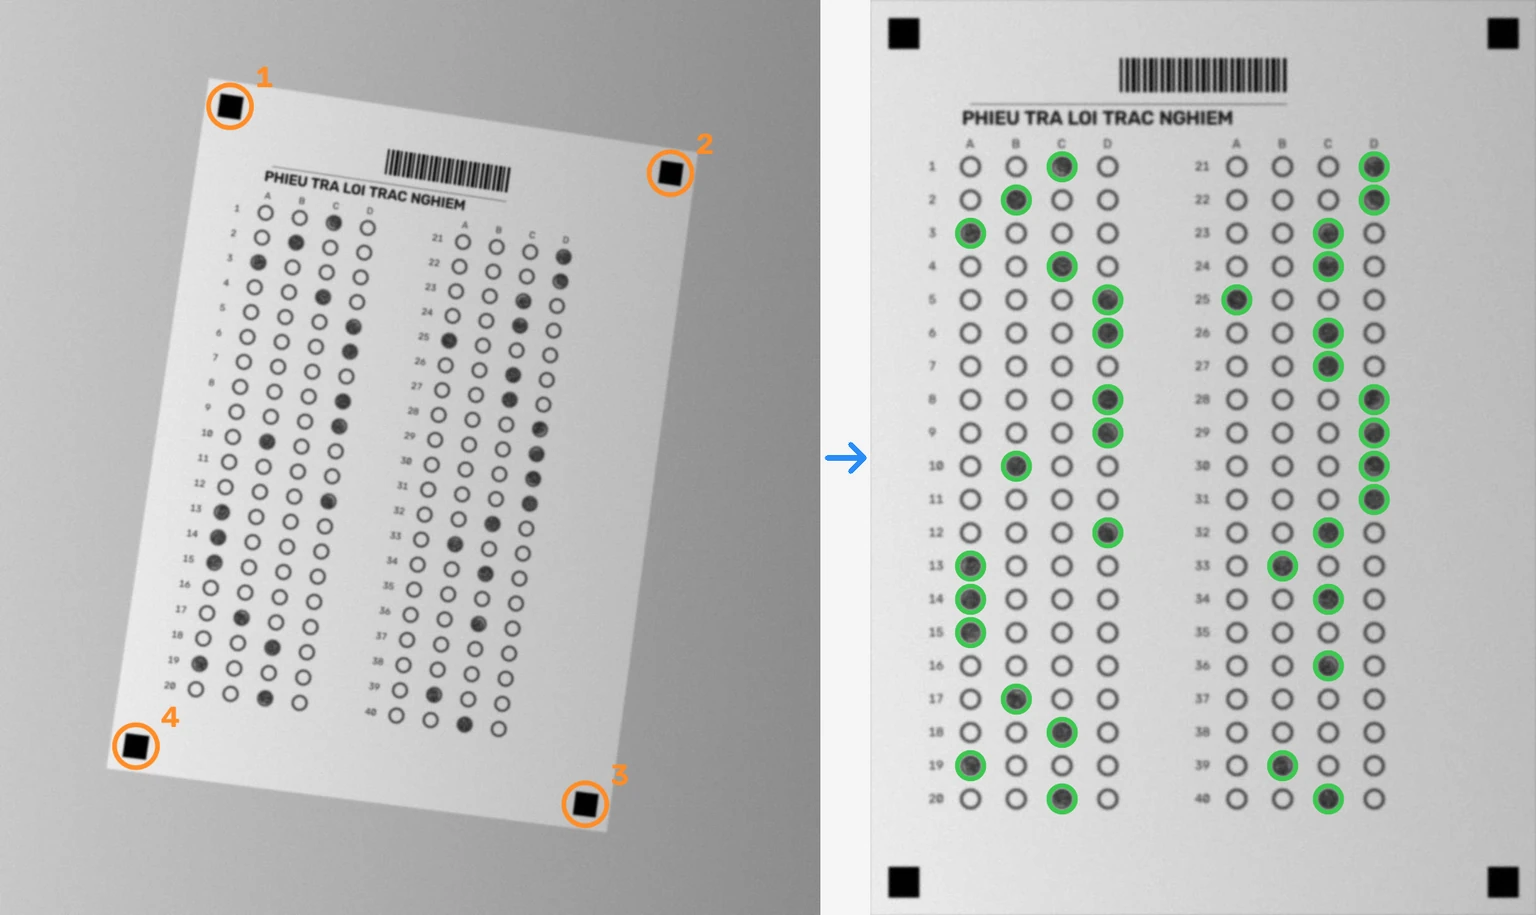
Bốn ô vuông ở góc: cách tìm và hai chỗ hỏng
Bộ tìm lọc các đường viền theo diện tích từ 900 đến 2.600 điểm ảnh, tỷ lệ hai cạnh không quá 1,4 và extent (diện tích đường viền chia diện tích hình chữ nhật xoay nhỏ nhất bao quanh nó) từ 0,88 trở lên. Hình vuông có extent gần 1, ô tròn chỉ khoảng 0,79. Phép lọc này loại mọi ô tròn và nét chữ. Bốn góc được chọn theo tổng và hiệu tọa độ: góc trên-trái có x+y nhỏ nhất, góc dưới-phải có x+y lớn nhất. Tài liệu Contours: Getting Started của OpenCV ghi rằng findContours tìm vật thể trắng trên nền đen, nên ảnh phải được nhị phân hóa ngược trước:
def find_markers(gray, how="adaptive", min_extent=0.88):
    """Trả về tâm bốn ô vuông ở góc theo thứ tự trên-trái, trên-phải, dưới-phải, dưới-trái, hoặc None."""
    blur = cv2.GaussianBlur(gray, (5, 5), 0)
    if how == "otsu":
        _, bw = cv2.threshold(blur, 0, 255, cv2.THRESH_BINARY_INV + cv2.THRESH_OTSU)
    else:   # so từng điểm ảnh với trung bình cửa sổ 101x101, nên nửa tối của ảnh không làm hỏng ngưỡng
        bw = cv2.adaptiveThreshold(blur, 255, cv2.ADAPTIVE_THRESH_MEAN_C, cv2.THRESH_BINARY_INV, 101, 50)
    cnts, _ = cv2.findContours(bw, cv2.RETR_EXTERNAL, cv2.CHAIN_APPROX_SIMPLE)
    cand = []
    for c in cnts:
        area = cv2.contourArea(c)
        if not 900 < area < 2600:
            continue
        (cx, cy), (w, h), _ = cv2.minAreaRect(c)
        if min(w, h) == 0 or max(w, h) / min(w, h) > 1.4 or area / (w * h) < min_extent:
            continue                      # hình vuông có extent gần 1, ô tròn chỉ khoảng 0,79
        m = cv2.moments(c)
        cand.append((m["m10"] / m["m00"], m["m01"] / m["m00"]))
    if len(cand) < 4:
        return None
    p = np.float32(cand)
    s, d = p.sum(1), p[:, 0] - p[:, 1]
    pts = np.float32([p[s.argmin()], p[d.argmax()], p[s.argmax()], p[d.argmin()]])
    if len({tuple(x) for x in pts.tolist()}) < 4:
        return None
    return pts
Cách nhị phân hóa ở bước này quyết định bộ tìm sống hay chết. Bảng đo 100 phiếu sạch trên bàn có độ xám khác nhau, so ngưỡng Otsu của cả ảnh với ngưỡng cục bộ cửa sổ 101 điểm ảnh:
| Độ xám của mặt bàn (giấy 245) | Otsu: phiếu bị từ chối | Cục bộ 101: phiếu bị từ chối |
|---|---|---|
| 255 | 0 trên 100 | 0 trên 100 |
| 245 | 0 trên 100 | 0 trên 100 |
| 200 | 100 trên 100 | 0 trên 100 |
| 120 | 100 trên 100 | 0 trên 100 |
| 40 | 100 trên 100 | 0 trên 100 |
Ở bàn xám 200, Otsu đặt ngưỡng 218 và coi mặt bàn là vật thể: chỉ còn một đường viền ngoài che 99,8% khung ảnh (1.882.251 trên 1.885.000 điểm ảnh), còn bốn ô vuông nằm trong lỗ của nó, nơi RETR_EXTERNAL không nhìn tới. Ở bàn xám 40, ngưỡng rơi vào 141 và mặt bàn dính với ô vuông. Tài liệu OpenCV mô tả Otsu cho ảnh có hai đỉnh histogram, và mặt bàn xám thêm đỉnh thứ ba nên Otsu tách sai chỗ. Bộ tìm dùng ngưỡng Otsu chỉ chạy khi bàn sáng ngang hoặc hơn giấy, một điều kiện hiếm trong ảnh thật. Bộ tìm trong bài dùng ngưỡng cục bộ cửa sổ 101 với C bằng 50, vì ô vuông đen chênh nền gần 245 mức xám; bước đo ô dùng C bằng 25.
Hai ca còn lại của bước này, cả hai đo trên cùng bộ tìm. Phiếu úp ngược 180° vẫn tìm đủ bốn ô vuông, vì bốn ô giống hệt nhau, nên phiếu được nắn ngược và cả ba bộ đọc chỉ đúng 4,56% đến 4,89% số câu, tức những câu bỏ trống. Góc nghiêng mạnh (mỗi góc lệch tối đa 60 điểm ảnh) làm 31 trên 200 phiếu bị từ chối: hình vuông méo thành hình thang có extent dưới 0,88. Hạ ngưỡng extent xuống 0,82 trên 100 phiếu đầu của cùng điều kiện (nên khác với 31 trên 200 ở trên) giảm số phiếu bị từ chối từ 14 xuống 2 mà 98 phiếu còn lại đọc đúng 100%.
Nhị phân hóa: cửa sổ cục bộ phải lớn hơn nhiều lần ô tròn
Tài liệu Image Thresholding của OpenCV mô tả ngưỡng toàn ảnh, dùng một giá trị cho cả ảnh, rồi nêu ngưỡng thích nghi cho ảnh có ánh sáng khác nhau giữa các vùng. Ngưỡng của mỗi điểm ảnh lấy từ một vùng nhỏ quanh nó: blockSize là kích thước vùng, C là hằng số trừ khỏi trung bình của vùng. Trang tài liệu không nói blockSize phải lớn cỡ nào so với vật cần tách, và đó là chỗ bài đo.
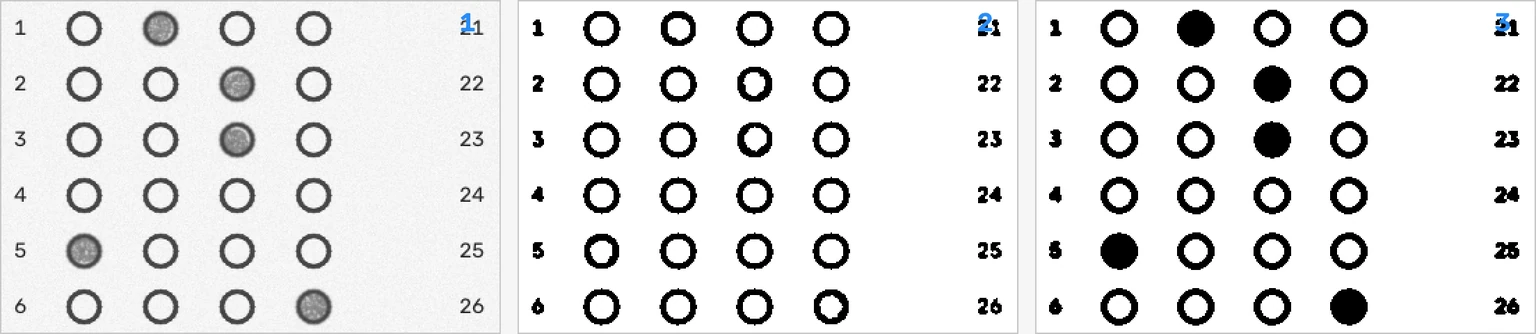
Thử trên 50 phiếu mỗi ô của bảng, giữ nguyên mọi tham số của bộ đọc B và chỉ đổi blockSize (đĩa mực rộng 22 điểm ảnh); cột còn lại là mức xám của nét chì:
| Chì xám | 41 | 61 | 81 | 101 | 151 |
|---|---|---|---|---|---|
| 100 | 93,15% | 100% | 100% | 100% | 100% |
| 140 | 4,60% | 100% | 100% | 100% | 100% |
| 180 | 4,60% | 4,60% | 4,60% | 99,10% | 100% |
Ở cửa sổ 41, một nét chì xám 140 biến mất khỏi ảnh nhị phân. Đo trên 40 ô tô của một phiếu chì 140, trung bình xám tại tâm ô là 150 và trung bình có trọng số Gaussian của cửa sổ 41 cũng là 149: chính đĩa chì kéo “nền” xuống bằng nó, nên điểm ảnh không tối hơn nền đủ C bằng 25. Với cửa sổ 101 trung bình nền là 205, cách 55 mức xám. Số 4,60% ở bảng là phần câu bỏ trống của 50 phiếu đầu, bộ đọc chỉ đúng ở đó. Cửa sổ 41 mất dấu chì 140. Muốn đọc nét chì nhạt, cửa sổ phải rộng hơn đĩa mực nhiều lần; 101 điểm ảnh, gần 5 lần đường kính ô, đọc được tới chì 180 ở mức 99,10% trên 50 phiếu (99,41% trên 200 phiếu của bảng kết quả).
Hàm fill_ratios chạy nhị phân hóa rồi lấy tỷ lệ mực trong đĩa của từng ô. Nhánh otsu là bộ đọc A, nhánh adaptive là bộ đọc B; nhánh dark gọi hàm darkness của bộ đọc D, trình bày ở mục sau:
def fill_ratios(warped, mode="adaptive", C=30, block=101):
    if mode == "dark":
        return darkness(warped)
    blur = cv2.GaussianBlur(warped, (5, 5), 0)
    if mode == "otsu":
        _, bw = cv2.threshold(blur, 0, 255, cv2.THRESH_BINARY_INV + cv2.THRESH_OTSU)
    else:
        bw = cv2.adaptiveThreshold(blur, 255, cv2.ADAPTIVE_THRESH_GAUSSIAN_C, cv2.THRESH_BINARY_INV, block, C)
    r_in = int(R * 0.65)
    ys, xs = np.mgrid[-r_in:r_in + 1, -r_in:r_in + 1]
    disc = np.hypot(xs, ys) <= r_in
    dy, dx = ys[disc], xs[disc]
    cx = np.array([[x for x, _ in bubble_xy(q)] for q in range(NQ)])
    cy = np.array([[y for _, y in bubble_xy(q)] for q in range(NQ)])
    vals = bw[cy[:, :, None] + dy, cx[:, :, None] + dx]      # (câu, ô, điểm ảnh trong đĩa)
    return (vals > 0).mean(axis=2).astype(np.float32)
Ngưỡng toàn ảnh hỏng khi ánh sáng lệch. Bộ đọc A (Otsu cả phiếu) đọc đúng 100% khi mép phải còn 66% độ sáng, chỉ còn 50,00% khi mép phải còn 50%, và 11,81% khi nửa phiếu nằm trong bóng; bộ đọc B đọc đúng 100% ở cả ba điều kiện.
Quy tắc quyết định: tỷ lệ lấp đầy, ô đậm nhất cùng hàng và điểm tối
Sau khi có tỷ lệ mực của bốn ô, hàm decide trả về kết quả cho từng hàng. Bộ đọc B coi một ô là đã tô khi tỷ lệ từ 0,30 trở lên và từ 80% tỷ lệ của ô đậm nhất cùng hàng trở lên. Ngưỡng 0,30 giữ được nét gạch chéo, còn quy tắc 80% bỏ các ô có tỷ lệ mực dưới 80% tỷ lệ của ô đậm nhất, như vết tẩy chỉ phủ một phần ô. Hàm trả – khi không ô nào vượt ngưỡng và * khi từ hai ô vượt:
def decide(ratios, t_abs=0.5, t_rel=0.0):
    """'-' là bỏ trống, chữ cái là một ô tô, '*' là tô nhiều hơn một ô."""
    ans = []
    for row in ratios:
        marked = [j for j, r in enumerate(row) if r >= t_abs and r >= t_rel * row.max()]
        ans.append("-" if not marked else LETTERS[marked[0]] if len(marked) == 1 else "*")
    return ans
Hình dưới in tỷ lệ cạnh từng ô và kết quả “đáp án thật / đáp án đọc được” ở cuối mỗi hàng; câu 7 là tô hai ô và được trả về *.
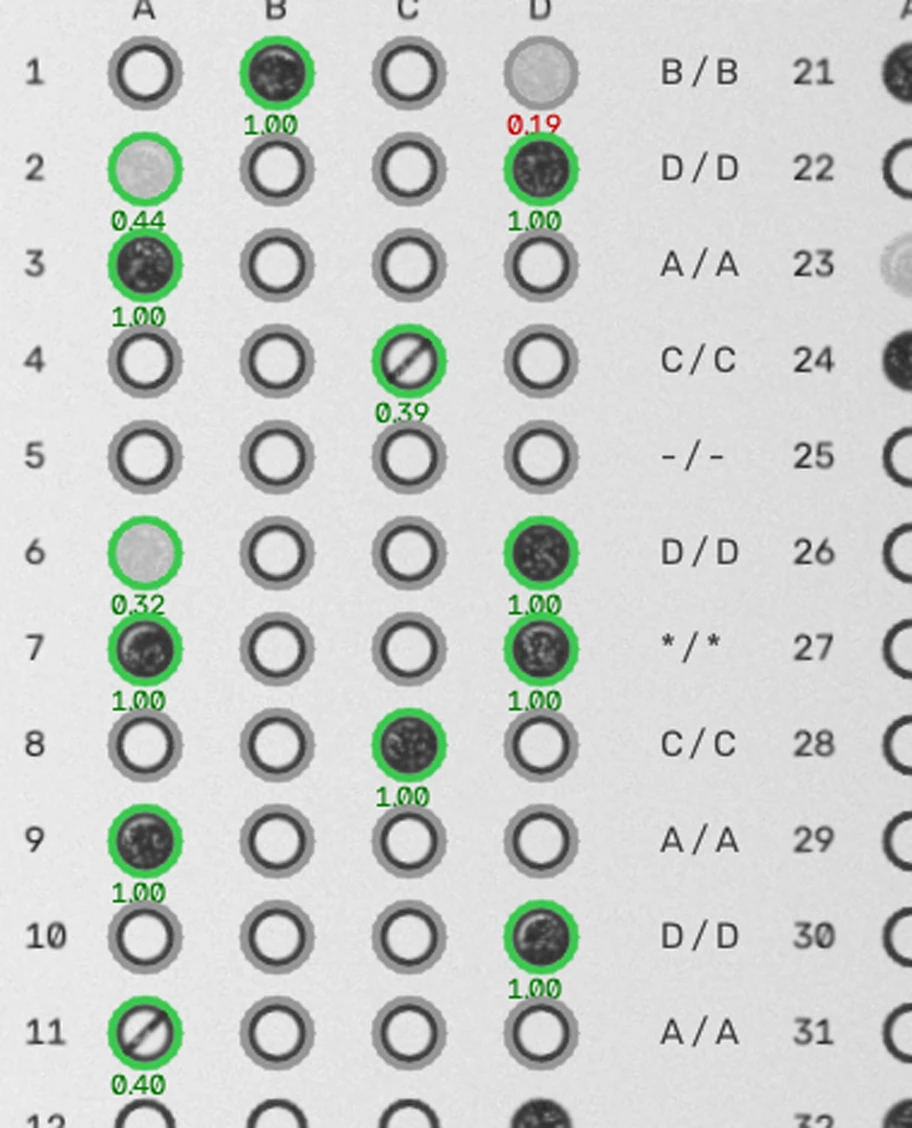
Tỷ lệ mực đo độ phủ, không đo độ đậm: nét chì xám 150 và nét chì đen đều cho tỷ lệ gần 1,00 sau khi nhị phân hóa, và vết tẩy phủ kín ô cũng cho 1,00 nếu đủ tối để vượt C. Bộ đọc D bỏ nhị phân hóa để giữ độ đậm. Điểm tối của ô là mức giấy (phân vị 90 của cửa sổ 51×51 quanh ô, tức giá trị mà 90% điểm ảnh trong cửa sổ không sáng hơn) trừ xám trung bình trong đĩa. Ô được coi là đã tô khi điểm từ 55 trở lên và từ 45% điểm của ô đậm nhất cùng hàng.
Cách so cường độ trung bình của từng ô này cùng họ với OMRChecker, dự án mã nguồn mở đọc phiếu bằng Python và OpenCV. Mã của dự án (core.py) lấy trung bình xám trong từng ô, sắp xếp rồi đặt ngưỡng ở khoảng nhảy lớn nhất giữa các giá trị. Mức nhảy tối thiểu mặc định là 25 mức xám, khai báo trong src/defaults/config.py của dự án. Bộ đọc D dùng ngưỡng cố định thay cho việc tìm khoảng nhảy.
def darkness(warped, win=51):
    """Mỗi ô: mức giấy (phân vị 90 của cửa sổ win x win) trừ xám trung bình trong đĩa của ô."""
    r_in = int(R * 0.65)
    ys, xs = np.mgrid[-r_in:r_in + 1, -r_in:r_in + 1]
    disc = np.hypot(xs, ys) <= r_in
    out = np.zeros((NQ, NOPT), np.float32)
    h = win // 2
    for q in range(NQ):
        for j, (x, y) in enumerate(bubble_xy(q)):
            paper = np.percentile(warped[y - h:y + h + 1, x - h:x + h + 1], 90)
            out[q, j] = paper - warped[y - r_in:y + r_in + 1, x - r_in:x + r_in + 1][disc].mean()
    return out
Hai bộ đọc đổi chỗ thắng thua ở các điều kiện về dấu tô; mỗi ô là tỷ lệ câu đọc đúng trên 200 phiếu. B thắng ở bóng đổ, gạch chéo và ô thứ hai nhạt, D thắng ở vết tẩy còn 25%:
| Điều kiện | Bộ đọc B (độ phủ) | Bộ đọc D (độ đậm) |
|---|---|---|
| Tẩy, chì còn 25% | 89,22% (862 câu bị báo tô hai ô) | 100% |
| Tẩy, chì còn 50% | 80,58% | 80,59% |
| Tô hai ô, ô thứ hai xám 150 | 100% | 99,52% (38 câu hai ô bị đọc thành một ô) |
| Bóng đổ nửa phiếu | 100% | 96,14% |
| Gạch chéo rộng 3,5 điểm ảnh | 100% | 99,65% |
Điểm tối của D đo trên 30 phiếu, theo trung bình (nhỏ nhất đến lớn nhất): dấu tô chì đen 185 (166 đến 200), chì xám 140 là 97 (88 đến 105), chì xám 180 là 62 (56 đến 67), chì xám 210 là 36 (32 đến 39). Ngưỡng tuyệt đối 55 nằm giữa chì 180 và chì 210. Chì 180 chỉ hơn ngưỡng khoảng 7 điểm. Chì 210 nằm dưới ngưỡng, nên cả ba bộ đọc đều bỏ sót nó.
Vết tẩy còn 25% chì có điểm 49 (45 đến 54), dưới ngưỡng 55, nên D bỏ qua. B thấy một ô phủ kín và báo tô hai ô. Bỏ quy tắc 80% (bộ đọc B0) làm điều kiện tẩy 25% xấu đi, từ 89,22% xuống 80,58%, tức mọi câu có tẩy đều sai (20% số câu). Dù đã có quy tắc 80%, B vẫn sai 862 trên 8.000 câu, tức 10,8%.
Vết tẩy còn 50% chì có điểm 95 (86 đến 103), gần bằng nét chì xám 140 (97) và vượt ngưỡng 45% của ô đậm nhất (83). Cả hai bộ đọc báo tô hai ô cho 1.554 trên 8.000 câu. Hai thứ đó trông giống nhau với chính người chấm. Hạ ngưỡng 55 để bắt chì nhạt hơn thì vết tẩy 25% lọt vào, nâng lên thì mất chì 180. Bóng đổ làm điểm của dấu tô chì đen rơi từ 185 xuống trung bình 116 (84 đến 198), và D mất độ chính xác ở đó; B không mất vì nhị phân hóa cục bộ đã trừ nền.
Gạch chéo là ca biên: tỷ lệ mực trung bình của nét rộng 3,5 điểm ảnh là 0,44, cách ngưỡng 0,30 một khoảng ngắn (từng nét dao động, như 0,39 và 0,40 ở hình trên). Đo thêm với 100 phiếu mà mọi câu đều gạch chéo, bộ đọc B đúng 72,78% khi nét rộng từ 1,5 đến 2,5 điểm ảnh (tỷ lệ mực trung bình 0,30, đúng bằng ngưỡng) và 100% khi nét rộng từ 3 điểm ảnh (tỷ lệ 0,44 trở lên). Ngưỡng 0,30 vì thế chọn theo nét gạch của script, không đại diện cho nét gạch của học sinh thật.
Đo độ chính xác theo ô, theo câu và theo phiếu
Cả ba bộ đọc dùng chung bộ tìm ô vuông ở trên và khác nhau ở bước nhị phân hóa và bước quyết định. Bảng đầu là các điều kiện về ảnh chụp, mỗi ô là tỷ lệ câu đọc đúng trên 200 phiếu giả lập; “bỏ trống” và “tô hai ô” được tính là kết quả đúng khi đáp án thật cũng như vậy:
| Điều kiện | A: Otsu cả phiếu | B: cục bộ 101 | D: điểm tối |
|---|---|---|---|
| Ảnh sạch | 100% | 100% | 100% |
| Xoay 3°, 10°, 30° | 100% | 100% | 100% |
| Xoay 180° | 4,56% | 4,89% | 4,56% |
| Nghiêng 20 điểm ảnh | 100% | 100% | 100% |
| Nghiêng 60 điểm ảnh (31 phiếu bị từ chối, 169 phiếu đọc) | 100% | 100% | 100% |
| Mờ 1,5; 3; 5 điểm ảnh | 100% | 100% | 100% |
| Sáng lệch: mép phải còn 80% và 66% | 100% | 100% | 100% |
| Sáng lệch: mép phải còn 50% | 50,00% | 100% | 100% |
| Bóng đổ nửa phiếu | 11,81% | 100% | 96,14% |
| JPEG chất lượng 20 | 100% | 100% | 100% |
| Kết hợp xoay, nghiêng, mờ, lệch sáng, chì 140, JPEG 40 | 100% | 100% | 100% |
Bảng thứ hai là các điều kiện về dấu tô, đo trên cùng 200 phiếu mỗi dòng. Ở các dòng có 4,69%, bộ đọc chỉ đúng ở những câu bỏ trống, chiếm 4,69% số câu của 200 phiếu (xác suất bỏ trống đặt là 5%):
| Điều kiện | A: Otsu cả phiếu | B: cục bộ 101 | D: điểm tối |
|---|---|---|---|
| Chì xám 100 và 140 | 100% | 100% | 100% |
| Chì xám 180 | 4,69% | 99,41% | 100% |
| Chì xám 210 | 4,69% | 4,69% | 4,69% |
| Gạch chéo rộng 3,5 điểm ảnh | 72,05% | 100% | 99,65% |
| Tẩy, chì còn 12% | 100% | 100% | 100% |
| Tẩy, chì còn 25% | 100% | 89,22% | 100% |
| Tẩy, chì còn 50% | 80,58% | 80,58% | 80,59% |
| Tô hai ô, cả hai đậm | 100% | 100% | 100% |
| Tô hai ô, ô thứ hai xám 150 | 100% | 100% | 99,52% |
Một con số trung bình che đi hai thứ. Thứ nhất là cái mẫu số: 8.000 câu có 32.000 ô và chỉ khoảng 7.600 ô là ô tô, nên tỷ lệ ô đúng luôn cao. Bài báo của Gyamfi và Missah (Advances in Science, Technology and Engineering Systems Journal, 2017) cho thấy đúng hiện tượng này trên phiếu quét. Độ chính xác dự đoán là 99,60% khi tỷ lệ ô tô tìm được (recall) là 92,50%. Khi bộ phiếu thử tăng từ 30 lên 150 phiếu, độ chính xác còn 98,82% trong lúc recall tụt xuống 76,23%. Thứ hai là mẫu số theo phiếu: bảng dưới đếm trên cùng các lần chạy, với chữ “sai” là số câu sai trên 8.000 câu của 200 phiếu:
| Bộ đọc và điều kiện | Câu đúng | Phiếu đúng cả 40 câu |
|---|---|---|
| B, chì xám 180 (47 câu sai, mỗi câu thiếu một ô tô) | 99,41% | 158 trên 200 (79%) |
| B với cửa sổ 41, sáng lệch mép phải còn 50% (10 câu sai) | 99,88% | 190 trên 200 (95%) |
| D, gạch chéo (28 câu sai) | 99,65% | 175 trên 200 (87,5%) |
| D, ô thứ hai xám 150 (38 câu sai) | 99,52% | 166 trên 200 (83%) |
| B với cửa sổ 41, bóng đổ (386 câu sai) | 95,17% | 28 trên 200 (14%) |
| B, tẩy còn 25% (862 câu sai) | 89,22% | 1 trên 200 (0,5%) |
Ở dòng đầu, 47 ô tô bị bỏ sót trên 32.000 ô cho độ chính xác theo ô là 99,85%, theo câu là 99,41%, và theo phiếu chỉ 79%. Cứ năm phiếu gần như có một phiếu sai điểm: 42 trên 200. Một câu sai chưa chắc người chấm nhìn thấy, nên số cần theo dõi là tỷ lệ phiếu phải kiểm lại bằng tay: bộ đọc trả * hoặc – cho các câu mơ hồ và đẩy phiếu có nhiều câu như vậy sang người xem.
README (trang giới thiệu dự án) của OMRChecker nêu “gần 100%” cho ảnh quét chất lượng tốt và “khoảng 90%” cho ảnh chụp điện thoại, không kèm cỡ mẫu hay định nghĩa độ chính xác (đọc ngày 03/11/2026). Phép đo của README khác phiếu, khác bộ đọc và khác cách tính độ chính xác so với các bảng trên, nên hai bên không đặt cạnh nhau được.
Ca đọc sai: triệu chứng, nguyên nhân, cách kiểm
Mỗi dòng là một lỗi đã tái hiện, kèm cách kiểm bằng các hàm ở trên. Cột cuối ghi cách sửa và cho biết cách sửa đó đã đo hay chưa:
| Triệu chứng | Nguyên nhân | Cách kiểm | Cách sửa |
|---|---|---|---|
| Toàn bộ phiếu bị từ chối ở bàn xám | Otsu coi mặt bàn là vật thể, ô vuông nằm trong lỗ của đường viền | In ngưỡng Otsu và đếm đường viền ngoài; thấy 1 đường viền phủ gần hết ảnh là dính | Ngưỡng cục bộ cửa sổ 101: 0 trên 100 phiếu bị từ chối ở mọi độ xám đã thử (đã đo) |
| Phiếu nghiêng mạnh bị từ chối | Ô vuông méo thành hình thang, extent dưới 0,88 | In extent của các ứng viên bị loại | Hạ extent xuống 0,82: từ chối giảm từ 14 xuống 2 trên 100 phiếu (đã đo) |
| Cả phiếu đúng khoảng 5% | Phiếu úp ngược, bốn ô vuông giống nhau nên không phân biệt được hướng | Mở phiếu đã nắn: chữ nằm ngược, đáp án đọc ra chủ yếu là bỏ trống | Làm một ô vuông khác ba ô còn lại để chọn hướng (chưa đo) |
| Nét chì nhạt biến mất | Cửa sổ nhị phân hóa quá nhỏ so với ô, hoặc điểm tối dưới ngưỡng | Hiện ảnh nhị phân của vài ô; so cửa sổ 41 với 101 như hình trên | Cửa sổ 101 điểm ảnh hoặc hơn (đã đo); chì xám 210 trên giấy 245 chưa bộ đọc nào đọc được |
| Ô bị tẩy báo thành tô hai ô | Tỷ lệ mực của vết tẩy phủ kín ô vượt ngưỡng | In tỷ lệ mực của mọi ô trong hàng bị báo * | Dùng điểm tối như bộ đọc D (đã đo, hết lỗi ở mức còn 25% chì); ở mức 50% chì chuyển phiếu sang người xem |
| Gạch chéo bị bỏ sót | Tỷ lệ mực của nét mảnh sát hoặc dưới ngưỡng 0,30 | Quét độ rộng nét và xem tỷ lệ trung bình | Đo ngưỡng trên nét gạch của chính phiếu thật; ngưỡng trong bài chọn theo nét của script |
Khi nào tự viết bộ đọc và khi nào dùng phần mềm chấm thi có sẵn
Tự viết bộ đọc hợp với phiếu một mẫu cố định, vì tọa độ mọi ô đã biết trước như ở bubble_xy. Mẫu phiếu đổi theo từng kỳ thi, hoặc ảnh chụp bằng điện thoại học sinh, thì đo lại các điều kiện ở hai bảng trên bằng ảnh thật của kỳ thi đó, và đếm tỷ lệ phiếu phải xem lại bằng tay. Phần phát sinh thêm của một hệ chấm thi ngoài đọc ô tô: ghép số báo danh và mã đề, trộn đề, lưu phiếu để chấm lại, và nhật ký chấm.
Trang phần mềm chấm thi trắc nghiệm so sánh các phần mềm hiện có, trong đó có phần mềm chấm bằng camera điện thoại và bằng máy quét. Bài trộn đề thi trắc nghiệm: thuật toán, thứ tự đáp án và chấm lại viết về phía mã đề, nơi bộ đọc này phải ghép đáp án theo đúng thứ tự đã trộn, và trang phần mềm trộn đề trắc nghiệm so sánh các công cụ tạo đề. Kỳ thi làm trên máy thì xem phần mềm thi trắc nghiệm online và phát hiện chuyển tab khi thi online; kho câu hỏi nằm ở phần mềm quản lý ngân hàng đề thi. Trường hoặc trung tâm cần hệ thống thi riêng thì xem trang phần mềm giáo dục của MONA Software, hoặc gọi hotline 1900 636 648.
Hỏi đáp
Nên chọn ô vuông ở góc hay dò vòng tròn bằng HoughCircles?
Bài dùng bốn ô vuông vì chúng cho đủ bốn điểm để nắn phối cảnh, rồi mọi ô tra từ tọa độ đã biết; HoughCircles chưa được đo ở đây. OMRChecker cũng đặt bố cục trong file template.json thay vì dò từng vòng tròn, và README của dự án ghi cờ tự căn lại phiếu –autoAlign đã bị bỏ vì chạy kém trên phiếu thông thường (đọc ngày 03/11/2026).
Ô tô đạt bao nhiêu phần trăm thì tính là đã tô?
Với phiếu giả lập của bài, bộ đọc B dùng 30% điểm ảnh trong đĩa là mực, kèm quy tắc từ 80% ô đậm nhất cùng hàng; bộ đọc A dùng 50%. Con số cho phiếu thật phải đo trên ảnh của chính kỳ thi.
Vì sao đĩa đo nhỏ hơn ô tròn in sẵn?
Ô in có vòng viền ở bán kính 10 đến 12 điểm ảnh; nếu đo cả ô, viền mực của ô trống đã chiếm phần của tỷ lệ mực. Bài đo trong đĩa bán kính 7 điểm ảnh (0,65 lần bán kính ô) nên ô trống cho tỷ lệ 0,00 như trong hình tỷ lệ mực ở trên. Bộ đọc A cũng đo đĩa này.
Ảnh chụp bằng điện thoại thật có đọc giống ảnh giả lập không?
Chưa biết. Bài chỉ đo trên phiếu do script vẽ. Phép đo không có ảnh thật nào. Mỗi điều kiện đổi một yếu tố, trừ dòng kết hợp. Kết quả nói về độ nhạy của từng bước với từng yếu tố, còn tỷ lệ đúng trên phiếu thật cần phép đo riêng với ảnh thật của kỳ thi.
Phiếu tô hai ô nên xử lý ra sao?
Trả kết quả * cho câu đó và để người xem. Bộ đọc không tự đoán. OMRChecker có tùy chọn filter_out_multimarked_files (mặc định tắt) để loại phiếu có nhiều ô tô khỏi kết quả tự động. Trong bài, câu tô hai ô cả hai đậm được đọc đúng 100% ở cả ba bộ đọc, còn tô hai ô khi ô thứ hai nhạt làm bộ đọc D bỏ sót 38 trên 8.000 câu.