

Phòng pháp chế của một công ty sản xuất đang dùng chatbot AI để đọc hợp đồng, rồi một hôm giám đốc hỏi: đối thủ nói họ có model riêng cho ngành, mình có cần làm một cái như vậy không? Harvey Tenet là ví dụ mới nhất để trả lời câu đó. Ngày 20/08/2026, Harvey, công ty bán phần mềm AI cho hãng luật, công bố Tenet: một bản Kimi K3 có trọng số mở được họ huấn luyện thêm cùng Fireworks cho việc pháp lý kéo dài nhiều bước. Bản này đang ở dạng xem trước nghiên cứu, chỉ nằm trong sản phẩm của Harvey và không bán riêng cho doanh nghiệp khác. Phần tốn kém của công thức là khoảng 150 GPU NVIDIA B300 chạy trong 2 tháng, ngoài tầm phần lớn doanh nghiệp Việt. Phần còn lại gồm chọn việc thật hẹp, tự viết bộ đề có tiêu chí chấm và giữ dữ liệu khách hàng ra ngoài thì một phòng pháp chế làm được trong tuần. Mọi chi tiết dưới đây MONA tra lại trên bài công bố của Harvey ngày 14/10/2026.
Harvey công bố gì về Tenet ngày 20/08/2026
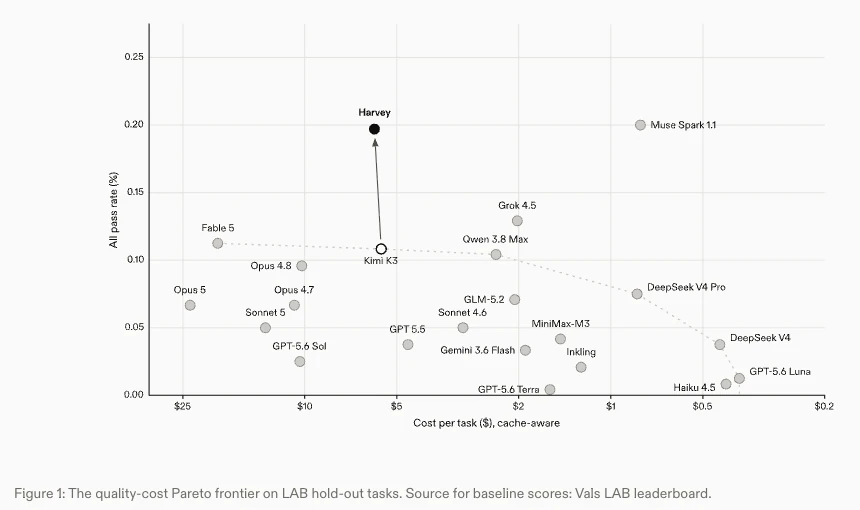
Bài công bố có tên Harvey Tenet Research Preview, do năm người trong nhóm nghiên cứu của Harvey đứng tên. Harvey kể rằng sáu tháng qua họ theo hai mục tiêu: xây năng lực pháp lý mạnh ngang model lớn trên nền model có trọng số mở, và làm ra hệ thống để chính các hãng luật tự huấn luyện model chuyên biệt của mình. Tenet là kết quả đầu tiên của hướng đó. Họ đo trên bộ Legal Agent Benchmark (LAB) do chính họ dựng, với những việc mà model chưa thấy lúc huấn luyện, và ghi kết quả so với bản Kimi K3 gốc như sau.
| Chỉ số trong bài công bố | Kết quả Harvey ghi | Cách đọc cho doanh nghiệp |
|---|---|---|
| Số việc hoàn thành trên LAB | Gần gấp đôi bản Kimi K3 gốc | Đo trên bộ đề của Harvey, chưa có bên độc lập chạy lại |
| Số việc hoàn thành trên LAB nhóm hợp đồng | Nhiều hơn 20% | Đây là nhóm gần nhất với việc rà hợp đồng của doanh nghiệp |
| Tỷ lệ làm đúng toàn bộ tiêu chí | Tăng 9 điểm phần trăm (LAB) và 2 điểm (LAB hợp đồng) | Phần tăng lớn nằm ở việc làm được nhiều hơn, phần làm trọn vẹn tăng ít hơn |
| Xếp hạng | Cao nhất trên LAB hợp đồng, thứ hai trên LAB | Bảng xếp hạng lấy điểm các model khác từ bảng LAB của Vals |
| Bộ đo kiến thức pháp lý (LegalBench, CUAD, MAUD) | Giữ được mức của bản gốc | Dạy thêm cách làm việc mà không làm rơi kiến thức cũ |
| Dữ liệu huấn luyện | Dữ liệu tổng hợp, dữ liệu pháp lý công khai, dữ liệu chuyên gia soạn | Không dùng dữ liệu của khách hàng nào |
Hai bộ đo bên ngoài mà Tenet chưa từng gặp trong lúc huấn luyện, APEX Agents (mảng luật doanh nghiệp) của Mercor và Redline Bench của Crosby, cũng cho kết quả cao hơn rõ so với bản gốc. Harvey dùng điểm này để nói model học được cách làm việc của nghề luật, thay vì thuộc đề. Đây cũng là phép thử mà bên mua nên đòi ở mọi model đã tinh chỉnh: đo trên bộ đề mà bên bán chưa từng dùng để dạy. Bài công bố không kèm file trọng số, không có model card và không có đường gọi API riêng; Harvey chỉ ghi rằng các năng lực này sẽ được đưa dần vào sản phẩm Harvey theo thời gian.
Harvey dạy thêm Kimi K3 bằng hồ sơ pháp lý mô phỏng
Cách Harvey dựng dữ liệu là phần đáng đọc kỹ nhất, vì nó cho thấy họ đầu tư vào đề bài và cách chấm nhiều hơn vào bản thân model. Mỗi môi trường huấn luyện là một vụ việc khép kín gồm ba thứ: một yêu cầu công việc viết như lời luật sư thành viên giao việc, dài trung bình khoảng 50 chữ; một bộ hồ sơ của khách hàng giả lập, trộn tài liệu chính với tài liệu phụ; và một bảng tiêu chí do chuyên gia viết, trung bình khoảng 50 tiêu chí đạt hay không đạt cho mỗi việc, việc lớn nhất có hàng trăm tiêu chí. Tổng cộng có khoảng 1.750 môi trường như vậy.
Agent được thả vào một không gian làm việc tách riêng, có công cụ tìm và đọc hồ sơ, soạn sản phẩm rồi ghi kết quả ra file. Một model khác đóng vai giám khảo, chấm theo bảng tiêu chí; sau khi so nhiều ứng viên, Harvey chọn Kimi 2.6 làm giám khảo vì cân được chất lượng và chi phí. Về kỹ thuật, họ dùng GSPO cùng một lớp LoRA hạng 64 phủ lên toàn mạng K3, tức là chỉ dạy thêm một lớp mỏng thay vì huấn luyện lại toàn bộ trọng số. Ở cuối phần huấn luyện, Harvey ghi một câu mà doanh nghiệp nào làm phần mềm có dữ liệu khách cũng có thể chép lại vào quy trình của mình.
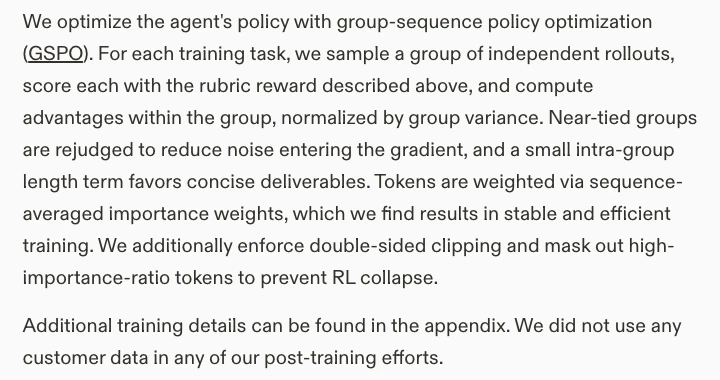
Với một công ty bán phần mềm cho hãng luật, hồ sơ vụ việc của khách là thứ không được đem đi đâu, vì vậy ba nguồn dữ liệu đều là dữ liệu tự tạo, dữ liệu công khai và dữ liệu do chuyên gia thuê viết. Ở Việt Nam, câu hỏi này còn gắn với luật: phần mềm xử lý dữ liệu cá nhân của khách phải theo Nghị định 356/2025 về dữ liệu cá nhân, và hệ thống AI dùng cho khách còn chịu thêm nghĩa vụ trong Luật Trí tuệ nhân tạo cho doanh nghiệp dùng chatbot và AI Agent.
Chi phí 150 GPU trong 2 tháng là phần doanh nghiệp Việt nên bỏ qua
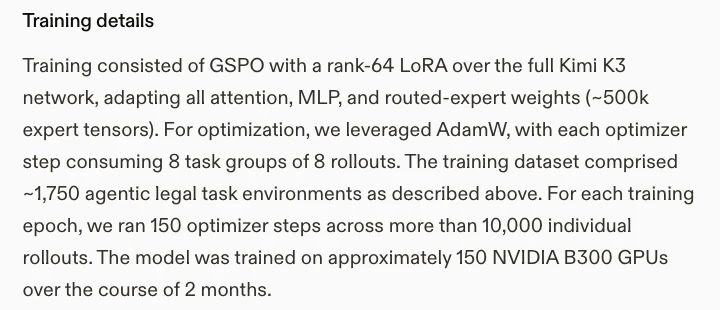
Phụ lục của bài công bố ghi rõ quy mô: mỗi bước tối ưu dùng 8 nhóm việc, mỗi nhóm 8 lần chạy thử, mỗi vòng có 150 bước trên hơn 10.000 lần chạy, và cả quá trình dùng khoảng 150 GPU NVIDIA B300 trong 2 tháng. Một lần chạy thử của agent có thể đi qua hơn 1.000 lượt và tiêu hàng trăm nghìn token. Đó là quy mô của một công ty vừa gọi thêm 550 triệu USD (theo dải thông báo trên chính trang Harvey ngày 14/10/2026), có sẵn bộ đề và đội chuyên gia tích từ nhiều năm bán sản phẩm.
Thiếu GPU chỉ là một nửa khoảng cách. Muốn dạy thêm một model thì phải có ba thứ cùng lúc: kho đề bài sát việc thật, bảng tiêu chí chấm do người trong nghề viết, và một bộ đo riêng để biết bản mới hơn bản cũ ở đâu. Harvey cảm ơn Mercor và Snorkel AI vì phần dữ liệu chuyên gia, nghĩa là ngay cả họ cũng thuê thêm người để soạn và rà dữ liệu. Một doanh nghiệp vừa bắt đầu dùng AI cho hợp đồng thường chưa có thứ nào trong ba thứ đó, vì thế tiền thuê máy chưa phải câu hỏi đầu tiên.
Điều Harvey nhấn mạnh thứ hai là chi phí. Họ thưởng cho những lần chạy đi thẳng vào việc và dùng ít token hơn ở cùng mức chất lượng, nhờ vậy điểm tăng rõ mà chi phí mỗi việc giữ nguyên. Hoá đơn AI tính theo giá mỗi token nhân với số token dùng, nên một model trả lời vòng vo thì đắt lên dù đơn giá không đổi. Đây là phần doanh nghiệp đo được ngay trên hệ thống đang chạy mà không cần huấn luyện gì.
Harvey chia việc nhỏ cho những model nhỏ hơn
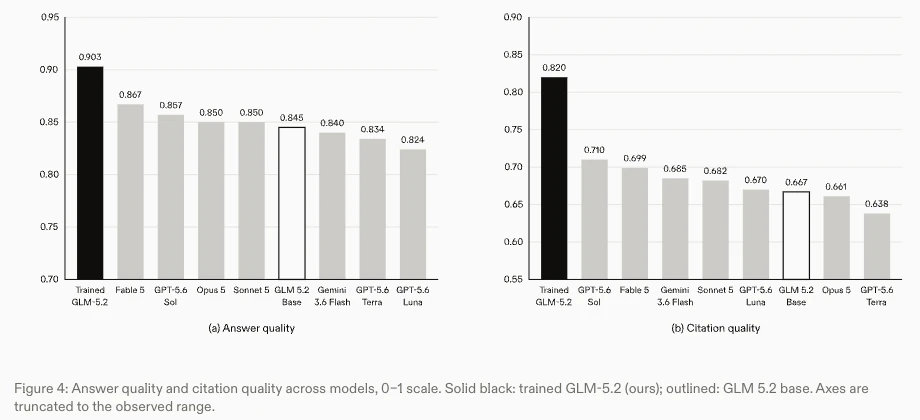
Ngoài Tenet, bài công bố còn kể ba hướng huấn luyện riêng cho từng loại việc, mỗi hướng làm thành công cụ hoặc agent con mà Tenet gọi tới khi cần. Ở việc rà soát tài liệu hàng loạt (Review Table, tối đa 10.000 tài liệu một lần), Harvey cùng Applied Compute dạy thêm một model GLM-5.2: so với model mạnh nhất họ đem so, chất lượng câu trả lời tăng 3,6 điểm và chất lượng trích dẫn tăng 12,1 điểm, với chi phí mỗi ô chỉ khoảng một phần mười. Ở việc tìm trong kho tri thức của hãng luật, Harvey cùng Engram dạy một model Qwen3.8-27B ghi nhớ kho hồ sơ, giảm 58% token và giảm 90% chi phí mỗi lượt tra.
Bài học cho người làm phần mềm khá rõ: một hệ thống AI tốt thường gồm nhiều model, mỗi model lo một việc vừa tầm, việc rà hàng nghìn tài liệu giao cho model nhỏ và rẻ, việc suy luận dài mới gọi model lớn. Tenet làm đúng như vậy, gặp việc rà bảng hay tra kho hồ sơ thì chuyển cho model con chuyên việc đó. Cách tính này cũng là nền của bài so sánh AI local hay tài khoản AI cho doanh nghiệp, và của bài tự chạy model mở Trung Quốc cho doanh nghiệp Việt trong cùng đợt bài này. Khi thiết kế một hệ thống agentic AI nhiều bước, chọn model cho từng bước quyết định hoá đơn hàng tháng nhiều hơn chọn một model đắt cho tất cả.
Phần doanh nghiệp làm theo được mà không cần GPU
Bỏ phần huấn luyện ra ngoài, công thức của Harvey còn lại một quy trình mà phòng pháp chế và phòng kỹ thuật của doanh nghiệp làm chung được, với chi phí chủ yếu là thời gian của người trong nghề. Trình tự dưới đây đi từ việc rẻ nhất tới việc tốn kém nhất, và phần lớn doanh nghiệp dừng ở bước bốn là đủ.
- Chọn một việc hẹp, lặp lại hằng tuần và có đúng sai rõ ràng, ví dụ rà điều khoản phạt và thời hạn thanh toán trong hợp đồng mua hàng, thay vì giao cho AI “việc pháp lý” nói chung.
- Viết 30 tới 50 đề bài từ hợp đồng đã ký, bỏ tên và số liệu định danh của đối tác, mỗi đề kèm đáp án do người phụ trách pháp chế chốt.
- Với mỗi đề, ghi bảng tiêu chí đạt hay không đạt theo kiểu Harvey: đã nêu đúng điều khoản chưa, trích đúng số điều chưa, có nhầm mốc ngày hay số tiền không.
- Cho model đang dùng chạy cả bộ, chấm theo bảng tiêu chí và ghi tổng token của mỗi việc để ra chi phí mỗi việc làm xong.
- Khi có model mới, chạy lại đúng bộ đề đó rồi so bằng số, thay vì so bằng cảm giác sau vài lần thử.
- Chỉ khi model sẵn có vẫn sai ở cùng một nhóm tiêu chí sau nhiều lần đổi model và sửa câu lệnh, mới tính tới chuyện dạy thêm một lớp LoRA nhỏ, và lúc đó bộ đề đã có sẵn để đo.
Bước hai và ba tốn công nhất, nhưng cũng là thứ không nhà cung cấp nào làm thay được, vì chỉ người trong công ty biết hợp đồng nào là chuẩn. MONA dùng cùng cách chấm bằng đáp án viết trước trong bài nghiên cứu cho Claude quét lỗ hổng plugin WordPress: đáp án được viết và cất riêng trước khi cho máy chạy, nên kết quả đọc lên mới có nghĩa. Với việc hợp đồng cụ thể, trang AI Agent pháp chế soạn và rà soát hợp đồng mô tả một agent làm đúng nhóm việc này, còn phần mềm quản lý hợp đồng là nơi lưu kho hợp đồng mà bộ đề lấy ra từ đó.
Những điều bài công bố chưa trả lời cho doanh nghiệp Việt
Tenet là bản xem trước nghiên cứu, nên nhiều chỗ còn để trống, và một doanh nghiệp đang chọn model cho phần mềm của mình cần biết các chỗ trống này trước khi trích lại bảng điểm. MONA đối chiếu bài công bố ngày 14/10/2026 và thấy năm điểm sau vẫn chưa có câu trả lời.
- Mọi bảng điểm đều do Harvey tự chạy trên bộ đo họ dựng, chưa có bên độc lập chạy lại.
- Không có file trọng số, model card hay API riêng, nên người ngoài Harvey chưa kiểm chứng được kết quả.
- Không có kết quả cho pháp luật Việt Nam hay hợp đồng tiếng Việt; LAB đang được mở rộng sang nhiều hệ thống pháp luật hơn nhưng chưa ghi nước nào.
- Không có giá bán riêng; chi phí chỉ được nói ở dạng so sánh với các model khác trên cùng bộ đo.
- Không có mốc ngày Tenet ra khỏi dạng xem trước để vào sản phẩm.
Khi một nhà cung cấp trong nước giới thiệu “model riêng cho ngành”, năm câu này cũng là năm câu đáng hỏi lại họ: ai chạy bảng điểm, có kiểm được không, đo trên tiếng Việt chưa, giá mỗi việc bao nhiêu, và bản đang bán là bản nào. Nhà cung cấp trả lời được bằng tài liệu thì bảng điểm của họ mới đáng tin. Trong bài về Agents API của OpenAI chỉ lưu dữ liệu tại Mỹ, câu hỏi dữ liệu nằm ở đâu cũng là câu doanh nghiệp phải tự đặt ra trước khi chọn nền tảng.
Hỏi đáp
Doanh nghiệp Việt mua được Harvey Tenet để dùng không?
Chưa. Tenet chỉ có trong nền tảng Harvey bán cho hãng luật và bộ phận pháp chế doanh nghiệp, và bài công bố ngày 20/08/2026 không kèm trọng số hay API riêng. Trên trang Harvey ngày 14/10/2026, Tenet vẫn mang nhãn Research Preview.
Kimi K3 mà Harvey dùng làm gốc là model gì?
Đó là model có trọng số mở do Moonshot AI phát hành tháng 07/2026, tải về được, dù chạy bản đầy đủ cần một cụm máy chủ lớn. Harvey chọn nó làm gốc vì model mở có đơn giá token rẻ hơn và cho phép dạy thêm, hai điều mà model đóng của các hãng lớn không cho làm.
Tự huấn luyện thêm một model riêng có rẻ hơn thuê model hãng lớn không?
Về lâu dài thì có thể, vì Harvey ghi chi phí mỗi việc giữ nguyên trong khi chất lượng tăng, và các model nhỏ của họ rẻ hơn tới mười lần ở từng việc hẹp. Nhưng phần đầu tư ban đầu gồm khoảng 150 GPU B300 trong 2 tháng, cộng đội chuyên gia soạn dữ liệu, nên phép tính chỉ có lời khi khối lượng việc đủ lớn và ổn định nhiều năm.
Một phòng pháp chế nhỏ bắt đầu từ đâu?
Bắt đầu bằng bộ đề: chọn 30 tới 50 câu hỏi hợp đồng hay tra nhất, mỗi câu kèm đáp án và tiêu chí chấm, rồi cho chatbot đang dùng làm thử. Bộ đề đó không tốn tiền phần mềm, và nó thành thước đo cho mọi lần đổi model về sau.
Có được dùng hợp đồng của khách để dạy AI không?
Harvey chọn không dùng dữ liệu khách hàng ở bất kỳ phần nào. Ở Việt Nam, hợp đồng thường chứa dữ liệu cá nhân của người ký, nên đem dữ liệu đó đi huấn luyện cần căn cứ xử lý theo Nghị định 356/2025 và điều khoản bảo mật trong chính hợp đồng. Cách an toàn là làm như Harvey: dùng dữ liệu tự tạo, dữ liệu công khai và hợp đồng đã xoá định danh.
Doanh nghiệp đã có kho hợp đồng và muốn đưa AI vào việc rà soát, nhưng chưa biết model nào đủ tốt cho hợp đồng tiếng Việt, có thể bắt đầu từ bộ đề chấm điểm như ở trên. MONA viết AI Agent theo yêu cầu cho từng quy trình hẹp, dựng kèm bộ đề và cách chấm để đo model trước khi chạy thật, và tách dữ liệu khách ra khỏi phần thử nghiệm ngay từ thiết kế. Gọi hotline 1900 636 648, gửi một nhóm hợp đồng mẫu đã xoá định danh, MONA đọc rồi trả lời việc nào giao cho AI trước thì có lợi nhất.