

Hợp đồng, hồ sơ nhân sự, bảng lương, danh sách khách là nhóm dữ liệu mà công ty nào cũng ngại gửi lên máy chủ của hãng AI nước ngoài, và cuộc bàn về chạy AI ngay trong công ty xưa nay hay tắc ở tiền máy. Ternary Bonsai 2 27B của PrismML làm con số đó nhỏ đi rất nhiều. Hãng mở trọng số ngày 17/09/2026 theo giấy phép Apache 2.0, gói nhẹ nhất nặng 5,93 GB, và theo công bố của hãng vẫn giữ 98,2% điểm của bản gốc Qwen3.8 27B, tức là đủ nhỏ để chạy trên một máy trạm có card đồ hoạ hoặc một máy Mac đời mới. Đổi lại có hai chỗ phải biết trước khi đặt mua máy: gói GGUF cần bản llama.cpp riêng của PrismML, và bộ 20 bài đo không có bài nào bằng tiếng Việt. Mọi số trong bài MONA tra lại trên trang của hãng ngày 14/10/2026.
PrismML công bố gì về Ternary Bonsai 2 27B
Bài công bố trên trang tin của PrismML đề ngày 17/09/2026 và tới ngày 14/10/2026 vẫn giữ nguyên các con số chính. Model dựng trên Qwen3.8 27B, tổng 27,36 tỷ tham số, mỗi trọng số được nén về một trong ba giá trị âm một, không hoặc dương một, kèm hệ số chia theo nhóm. Bề rộng thật là 1,72 bit mỗi trọng số, bản đóng gói PTQ1_0 ghi 1,76 bit. Model nhận chữ và ảnh, trả về chữ, ngữ cảnh tối đa 262.144 token.
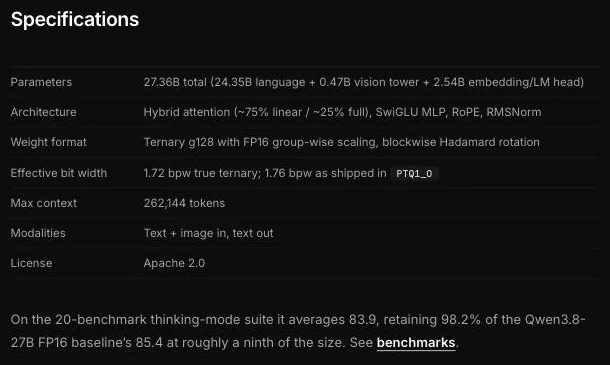
Con số được nhắc nhiều nhất là điểm trung bình 83,9 trên bộ 20 bài đo ở chế độ suy nghĩ, so với 85,4 của bản Qwen3.8 27B chạy FP16, tức giữ 98,2% ở khoảng một phần chín dung lượng. Bản Bonsai 27B đầu tiên của chính hãng ra hồi tháng 7 chỉ giữ được khoảng 95%. Bảng dưới gom các thông số doanh nghiệp cần khi tính chuyện chạy tại chỗ.
| Mục | Ternary Bonsai 2 27B | Ghi chú |
|---|---|---|
| Ngày công bố | 17/09/2026 | Trang tin PrismML |
| Model gốc | Qwen3.8 27B | Kiến trúc chú ý lai, khoảng 75% lớp tuyến tính |
| Tham số | 27,36 tỷ | Gồm 0,47 tỷ cho phần đọc ảnh |
| Gói nhẹ nhất | 5,93 GB (GGUF PTQ1_0) | Cần bản llama.cpp của PrismML |
| Điểm trung bình 20 bài đo | 83,9, bản gốc 85,4 | Giữ 98,2%, do hãng tự đo |
| Ngữ cảnh | 262.144 token | Chữ và ảnh vào, chữ ra |
| Giấy phép | Apache 2.0 | Dùng thương mại không kèm điều kiện riêng |
Apache 2.0 cho dùng thương mại, cho sửa và phát hành lại, chỉ đòi giữ thông báo bản quyền và ghi rõ chỗ đã sửa. Doanh nghiệp đem model về chạy trong hệ thống nội bộ hay gắn vào phần mềm bán cho khách đều khỏi xin thêm phép. Đây là chỗ khác với giấy phép qwen-community-1.0 của chính model gốc họ Qwen3.8, vốn buộc xin phép riêng khi kinh doanh dịch vụ cho thuê model. Với bộ phận pháp chế, một giấy phép quen thuộc như Apache 2.0 đọc nhanh hơn hẳn.
Ba gói tải của Bonsai 2 27B và nên chọn gói nào
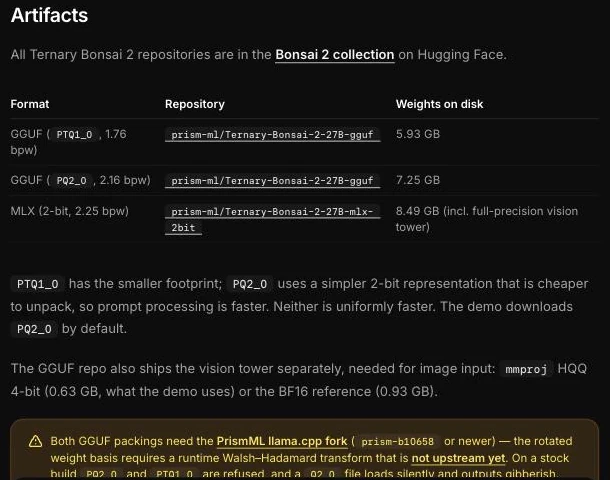
Tài liệu trên docs.prismml.com liệt kê ba gói: GGUF PTQ1_0 nặng 5,93 GB, GGUF PQ2_0 nặng 7,25 GB, và gói MLX 2 bit cho máy Mac nặng 8,49 GB vì kèm nguyên phần đọc ảnh ở độ chính xác đầy đủ. Hai gói GGUF cần thêm một tệp đọc ảnh riêng, 0,63 GB ở bản nén hoặc 0,93 GB ở bản BF16. Chỉ hỏi đáp trên chữ thì bỏ qua tệp này được. Cần đọc ảnh chứng từ thì cộng thêm phần đó vào bộ nhớ khi tính máy.
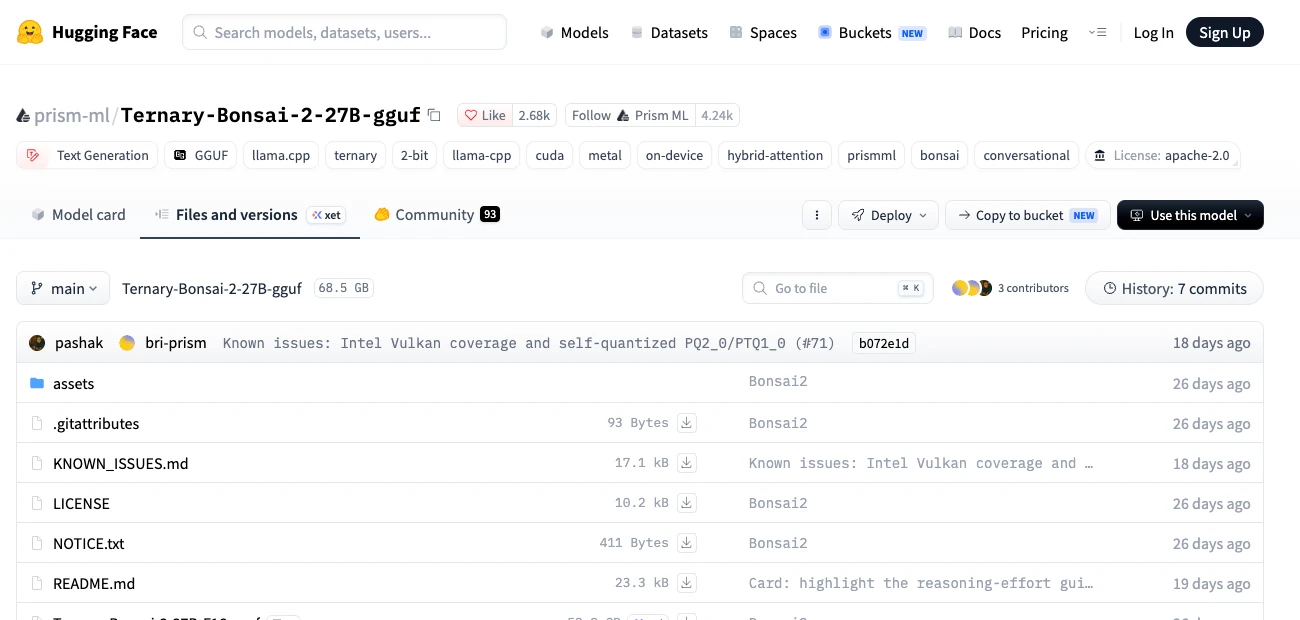
Kho GGUF trên Hugging Face nặng 68,5 GB vì chứa cả bản F16 chưa nén, riêng tệp đó đã 53,81 GB. Đặt cạnh tệp PTQ1_0 5,95 GB mà Hugging Face đo được thì đúng là nhỏ hơn khoảng chín lần, khớp lời hãng. Tài liệu nói PTQ1_0 nhỏ hơn, còn PQ2_0 giải nén đơn giản hơn nên xử lý phần câu hỏi đầu vào nhanh hơn, và không gói nào nhanh hơn hẳn trong mọi việc. Bản demo của hãng mặc định tải PQ2_0.
Với máy trạm có card NVIDIA, gói PQ2_0 7,25 GB là lựa chọn ít rủi ro nhất vì đó là gói hãng dùng cho bản demo. Với máy Mac, gói MLX 8,49 GB chạy trên bản MLX thông thường, khỏi cài thêm gì, nên đó là đường ít vấp nhất cho đội chưa từng vận hành model tại chỗ. Gói 5,93 GB chỉ đáng chọn khi bộ nhớ thật sự chật.
Bẫy lúc cài Bonsai 2 27B mà bản tin ít nhắc
Khung cảnh báo trong tài liệu ghi rằng cả hai gói GGUF cần bản llama.cpp riêng của PrismML, từ phiên bản prism-b10658 trở lên, vì cách xoay trọng số đòi một phép biến đổi chưa có trong llama.cpp bản gốc. Câu tiếp theo mới là câu đội kỹ thuật cần nhớ: trên bản dựng thông thường, hai gói PQ2_0 và PTQ1_0 bị từ chối thẳng, còn một tệp Q2_0 thì nạp êm rồi trả ra chữ vô nghĩa. Gói MLX không dính lỗi này. Lỗi kiểu đó không báo gì, người vận hành dễ tưởng model kém trong khi thật ra mình nạp sai gói.
Bẫy thứ hai nằm trong tệp lỗi đã biết mà PrismML cập nhật lần cuối ngày 23/09/2026. Model suy nghĩ trước khi trả lời, phần suy nghĩ tính vào giới hạn đầu ra, nên đặt giới hạn nhỏ là nhận về câu trả lời rỗng hoặc cụt. Mặc định mức suy nghĩ là xhigh, cao nhất. Ai quen gọi API với giới hạn vài trăm token sẽ vấp ngay lần đầu.
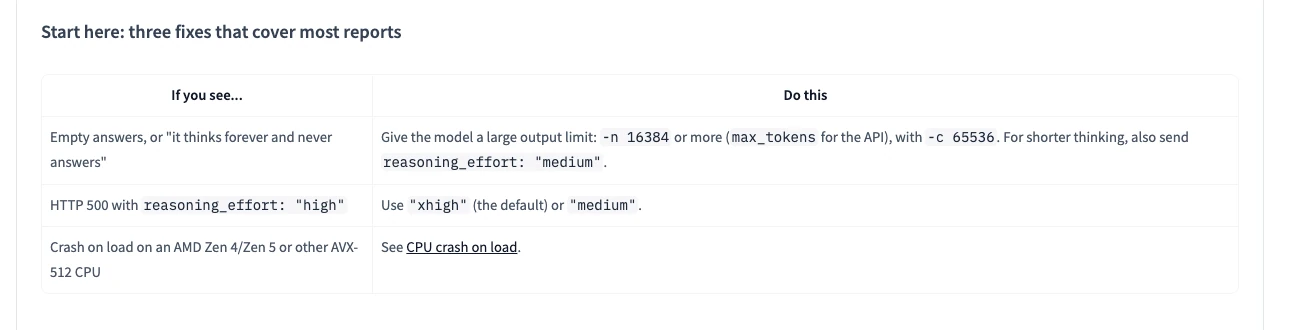
Hãng ghi rằng đây là lỗi được báo nhiều nhất, kể cả các báo cáo chê chất lượng câu trả lời bằng ngôn ngữ khác tiếng Anh. Với người thử bằng tiếng Việt, chi tiết đó quan trọng: một lần thử với giới hạn đầu ra 256 token rồi kết luận model viết tiếng Việt dở là kết luận sai. Cách làm hãng khuyên là đặt giới hạn đầu ra từ 16.384 token, ngữ cảnh 65.536 token, và gửi mức suy nghĩ medium, mức mà tài liệu ghi là chính xác gần bằng mặc định xhigh mà tốn ít hơn khoảng một phần ba số token. Mức high thì trả lỗi HTTP 500, còn mức low gần như không rút ngắn được gì.
Bẫy thứ ba dành cho việc đọc ảnh. Trên Metal của máy Mac, Vulkan hoặc chỉ chạy bằng CPU, ảnh lớn bị hạ xuống khoảng 1.024 token thị giác theo mặc định; trên CUDA và ROCm thì không giới hạn. Đọc hoá đơn hay hợp đồng scan chữ nhỏ trên máy Mac thì phải chỉnh biến BONSAI_IMAGE_MAX_TOKENS, không thì chữ nhỏ bị nhoè trước khi tới model.
Tốc độ và điện năng PrismML công bố cho Bonsai 2 27B
Trang công bố ghi model đạt tới 143 token mỗi giây trên card NVIDIA GeForce RTX 5090 và 46,8 token mỗi giây trên chip M5 Max của Apple. Trên RTX 4090, model tiêu thụ 0,714 mWh cho mỗi token, và hãng nói con số đó tiết kiệm điện hơn 40% so với một model 8 tỷ tham số chạy độ chính xác đầy đủ. Hãng còn ghi model chạy trên card NVIDIA qua CUDA và trên máy Mac, iPhone, iPad qua MLX. MONA chưa đo lại các con số này.
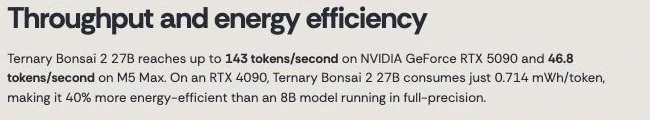
Quy ra việc thật: sinh 1 triệu token đầu ra tốn khoảng 0,71 kWh điện cho riêng card RTX 4090 theo con số của hãng, và ở tốc độ 143 token mỗi giây thì mất gần 2 giờ chạy liên tục trên RTX 5090. Cả hai con số đều đo trên phần cứng cao cấp, chưa có số cho card phổ thông hay máy Mac văn phòng đời thấp, và hãng cũng không ghi mức bộ nhớ tối thiểu. Tiền ở đường này chuyển từ tiền mỗi lượt gọi sang tiền máy mua một lần cộng tiền điện, nên nó chỉ rẻ khi máy được dùng đều mỗi ngày.
Khi nào chạy Bonsai 2 27B tại chỗ hợp hơn gọi API
So với các model mở trọng số khác trong cùng đợt, khoảng cách dung lượng rất lớn. MiMo-V2.6 Flash của Xiaomi nặng 178 GB và cần dàn nhiều card, Qwen3.8-Flash-Next nặng khoảng 360 GB ở BF16, còn Bonsai 2 27B gói nhẹ nhất dưới 6 GB. Đó là lý do model này đáng thử với ba nhóm việc: hỏi đáp trên hợp đồng và quy trình nội bộ, tóm tắt hồ sơ nhân sự, rút dữ liệu từ chứng từ có thông tin khách. Ba việc đó đều chạm tới dữ liệu cá nhân, mà Nghị định 356/2025 về dữ liệu cá nhân đặt thêm nghĩa vụ khi chuyển ra ngoài.
Ở chiều ngược lại, model gọi qua API vẫn là lựa chọn gọn hơn cho việc khó và việc cần nhanh. Một bản nén từ model 27 tỷ tham số khó theo kịp các model lớn nhất ở suy luận dài nhiều bước, và tổng đài trả lời khách lúc đông cần tốc độ ổn định mà một máy trạm đơn lẻ khó giữ. Các bài cùng loạt về Grok 4.7 tính giá gấp đôi khi vượt 200 nghìn token và Qwen3.8-Omni-Flash nghe cuộc gọi cho thấy phía API có cách tính tiền riêng cần đọc kỹ. Bài nghiên cứu AI local hay tài khoản AI cho doanh nghiệp của MONA chia việc nào chạy ở đâu, kèm giá máy và giá thuê bao đã tra.
Thử Bonsai 2 27B trên tài liệu tiếng Việt của công ty
Chưa có bài đo tiếng Việt thì phép thử phải làm trên chính tài liệu của mình, và làm trước khi mua máy. Thứ tự dưới đây dùng máy sẵn có trước, chỉ mua thêm khi kết quả đạt.
- Chọn 200 câu hỏi tiếng Việt từ hợp đồng, quy trình và hồ sơ đã ẩn danh, viết sẵn đáp án đúng trước khi chạy.
- Cài gói MLX trên một máy Mac sẵn có, hoặc gói PQ2_0 kèm bản llama.cpp của PrismML trên máy có card NVIDIA, đặt giới hạn đầu ra 16.384 token và mức suy nghĩ medium.
- Chạy cùng bộ câu trên một model gọi qua API mà công ty đang dùng để có mốc so.
- Chấm tay từng câu theo ba ý: trích đúng điều khoản, đọc đúng số tiền, nêu đúng ngày tháng.
- Ghi thời gian trả lời từng câu trên máy thật, nhân với số câu mỗi ngày để biết một máy gánh được bao nhiêu người dùng.
Kết quả bước 4 quyết định có mua máy hay không; bước 5 quyết định mua máy cỡ nào. Nếu tỷ lệ đúng thấp, thử lại một lượt với mức suy nghĩ xhigh và giới hạn đầu ra lớn hơn trước khi bỏ. Còn nếu kết quả gần bằng model API thì phép tính tiền máy cộng tiền điện mới bắt đầu có nghĩa. Muốn cho model đọc thẳng dữ liệu trong phần mềm nội bộ thay vì dán tay, cách nối an toàn được bàn trong bài MCP server là gì, còn tiêu chí chọn việc giao cho máy nằm ở bài AI Agent là gì.
Hỏi đáp
Ternary Bonsai 2 27B nặng bao nhiêu và chạy trên máy nào?
Gói nhẹ nhất GGUF PTQ1_0 nặng 5,93 GB, gói PQ2_0 7,25 GB, gói MLX cho máy Mac 8,49 GB. PrismML công bố tốc độ trên RTX 5090 và M5 Max, nhưng không ghi mức bộ nhớ tối thiểu, nên máy cụ thể phải tự thử với độ dài ngữ cảnh mình cần.
Bonsai 2 27B có dùng thương mại được không?
Được. Giấy phép Apache 2.0 cho dùng thương mại, sửa và phát hành lại, chỉ cần giữ thông báo bản quyền và ghi rõ chỗ đã sửa.
Vì sao chạy bằng llama.cpp lại ra chữ vô nghĩa?
Hai gói GGUF cần bản llama.cpp riêng của PrismML từ prism-b10658. Bản thông thường từ chối hai gói đó, còn tệp Q2_0 thì nạp được nhưng trả ra chữ vô nghĩa mà không báo lỗi.
Bonsai 2 27B có trả lời tiếng Việt tốt không?
Bộ 20 bài đo của hãng không có bài tiếng Việt. Tệp lỗi đã biết ghi rằng nhiều báo cáo chê chất lượng ở ngôn ngữ khác tiếng Anh thật ra do giới hạn đầu ra quá nhỏ, nên thử với giới hạn 16.384 token trước khi kết luận.
Model nén còn giữ được bao nhiêu chất lượng so với bản gốc?
Theo PrismML, điểm trung bình 83,9 so với 85,4 của Qwen3.8 27B FP16 trên 20 bài đo ở chế độ suy nghĩ, tức giữ 98,2%. Đây là số hãng tự đo, chưa có bên độc lập kiểm lại trên tiếng Việt.
Một model chạy được trên máy trạm mới là nửa việc; nửa còn lại là nối nó vào đúng chỗ dữ liệu đang nằm, phân quyền ai được hỏi gì, ghi lại câu hỏi để kiểm, và có người trực khi máy lỗi. MONA dựng phần đó trong dịch vụ viết AI Agent theo yêu cầu, chạy trên máy chủ của chính doanh nghiệp khi hợp đồng hay hồ sơ nhân sự không được rời công ty, và nối vào hệ thống sẵn có qua hướng viết phần mềm theo yêu cầu. Gọi hotline 1900 636 648 để bàn trên loại tài liệu và số người dùng cụ thể.