

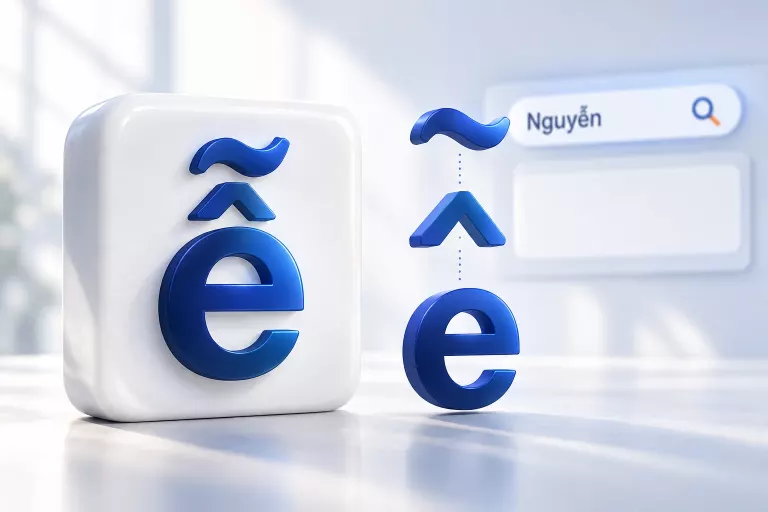
Tìm “Nguyễn” không ra dù dữ liệu có đúng chữ đó là do một chữ ê được lưu theo hai cách: NFC (một mã Unicode) và NFD (chữ e cộng hai dấu rời). Trên MySQL 8.4.8, hai dạng này là hai chuỗi khác nhau ở cột utf8mb4_bin, utf8mb4_general_ci và ba collation tiếng Việt. Cách sửa gồm ba việc: đổi mọi chuỗi sang NFC trước khi ghi và trước khi tìm, viết lại các dòng NFD đang có trong bảng, rồi tìm không dấu trên cột utf8mb4_0900_ai_ci. Mọi kết quả trong bài đo ngày 26/10/2026 trên MySQL 8.4.8 và Python 3.9.6; MariaDB và các bản MySQL khác chưa đo.
Hai chữ Nguyễn giống nhau trên màn hình nhưng dài 8 và 10 byte
NFC (Normalization Form C) ghép chữ và dấu thành một mã Unicode. NFD (Normalization Form D) tách thành chữ gốc cộng các dấu rời. Unicode coi hai dạng là cùng một chữ, nhưng so sánh nhị phân thì chúng là hai chuỗi khác nhau. Hàm unicodedata.normalize của Python đổi giữa hai dạng:
import unicodedata as u
nfc = u.normalize("NFC", "Nguyễn")
nfd = u.normalize("NFD", "Nguyễn")
for n, s in (("NFC", nfc), ("NFD", nfd)):
    print(n, s, "len=", len(s), "bytes=", len(s.encode()), [f"U+{ord(c):04X}" for c in s])
print("==", nfc == nfd, "| bằng nhau sau NFC:", u.normalize("NFC", nfd) == nfc)

NFC Nguyễn len= 6 bytes= 8 ['U+004E', 'U+0067', 'U+0075', 'U+0079', 'U+1EC5', 'U+006E']
NFD Nguyễn len= 8 bytes= 10 ['U+004E', 'U+0067', 'U+0075', 'U+0079', 'U+0065', 'U+0302', 'U+0303', 'U+006E']
== False | bằng nhau sau NFC: True
Chữ ễ ở dạng NFC là một mã (U+1EC5). Ở dạng NFD, ễ thành ba mã: e (U+0065), dấu mũ (U+0302) và dấu ngã (U+0303). Quy tắc này nằm trong Unicode Standard Annex #15 (UAX #15), bản 18.0.0 sửa đổi ngày 12/08/2026. Các chuỗi tương đương chính tắc cho cùng một kết quả sau khi chuẩn hóa, còn so sánh nhị phân chuỗi chưa chuẩn hóa coi chúng là khác nhau.
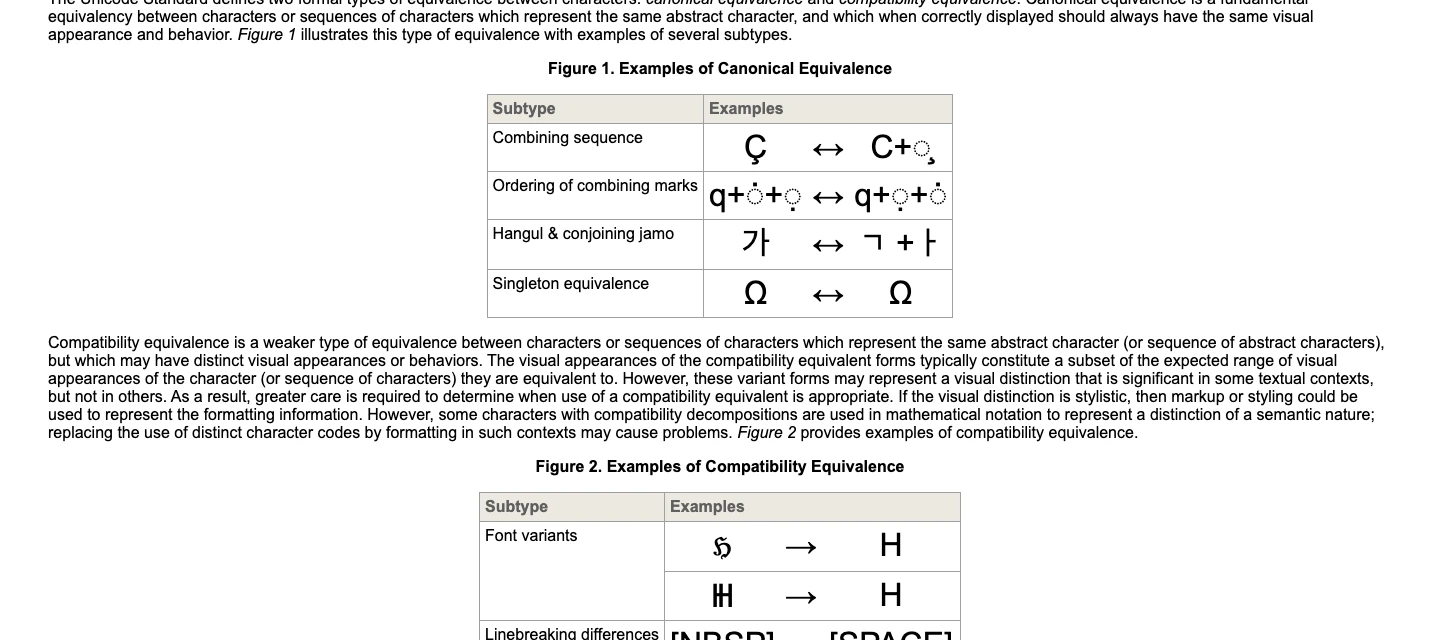
Chữ đ là ngoại lệ cần nhớ: Python cho thấy normalize("NFD", "đ") vẫn là một mã U+0111, tức đ không có dạng tách.
Cùng một phép so sánh, collation khác nhau cho kết quả khác nhau
Bảng thử có bảy dòng: “Nguyễn” dạng NFC (id 1) và NFD (id 2), “Nguyen” (id 3), “Nguyên” (id 4), cùng “Đặng” NFC, NFD và “Dang”. Cột ten khai báo utf8mb4_0900_ai_ci, còn mỗi truy vấn dưới đây ghi COLLATE rõ để so từng collation. Câu lệnh SQL trong bài được viết hoa từ khóa cho dễ đọc, kết quả là nguyên văn lần chạy cuối. Câu hỏi là dòng nào trả về khi gõ WHERE ten = 'Nguyễn' (chuỗi gõ vào ở dạng NFC):
mysql> SELECT 'utf8mb4_bin' collation_used, GROUP_CONCAT(id ORDER BY id) ids FROM khach WHERE ten COLLATE utf8mb4_bin = 'Nguyễn'
    -> UNION ALL SELECT 'utf8mb4_vi_0900_ai_ci', GROUP_CONCAT(id ORDER BY id) FROM khach WHERE ten COLLATE utf8mb4_vi_0900_ai_ci = 'Nguyễn'
    -> UNION ALL SELECT 'utf8mb4_0900_ai_ci', GROUP_CONCAT(id ORDER BY id) FROM khach WHERE ten COLLATE utf8mb4_0900_ai_ci = 'Nguyễn';
+-----------------------+---------+
| collation_used        | ids     |
+-----------------------+---------+
| utf8mb4_bin           | 1       |
| utf8mb4_vi_0900_ai_ci | 1,4     |
| utf8mb4_0900_ai_ci    | 1,2,3,4 |
+-----------------------+---------+
Cột utf8mb4_bin chỉ trả dòng 1. Cột utf8mb4_vi_0900_ai_ci trả dòng 1 và dòng 4 (“Nguyên”, vì tiếng Việt bỏ qua dấu thanh nhưng giữ ê khác e), mà bỏ sót dòng 2, chính là “Nguyễn” dạng NFD. Cột utf8mb4_0900_ai_ci trả cả bốn dòng, kể cả “Nguyen” không dấu. Để thấy rộng hơn, bảng dưới so bốn cặp chuỗi trên bảy collation:
| Collation | Nguyễn NFC = NFD | Nguyễn = Nguyen | Nguyễn = Nguyên | Đặng = Dang |
|---|---|---|---|---|
| utf8mb4_bin | khác | khác | khác | khác |
| utf8mb4_general_ci | khác | bằng | bằng | khác |
| utf8mb4_unicode_ci | bằng | bằng | bằng | khác |
| utf8mb4_0900_ai_ci | bằng | bằng | bằng | bằng |
| utf8mb4_0900_as_cs | bằng | khác | khác | khác |
| utf8mb4_vi_0900_ai_ci | khác | khác | bằng | khác |
| utf8mb4_vietnamese_ci | khác | khác | bằng | khác |
Từ bảng này: chọn utf8mb4_0900_ai_ci khi cần tìm không dấu và dữ liệu có thể lẫn NFD, chọn utf8mb4_0900_as_cs khi cần phân biệt dấu mà vẫn gộp NFC với NFD, và chỉ dùng collation tiếng Việt để sắp xếp sau khi mọi dòng đã là NFC.
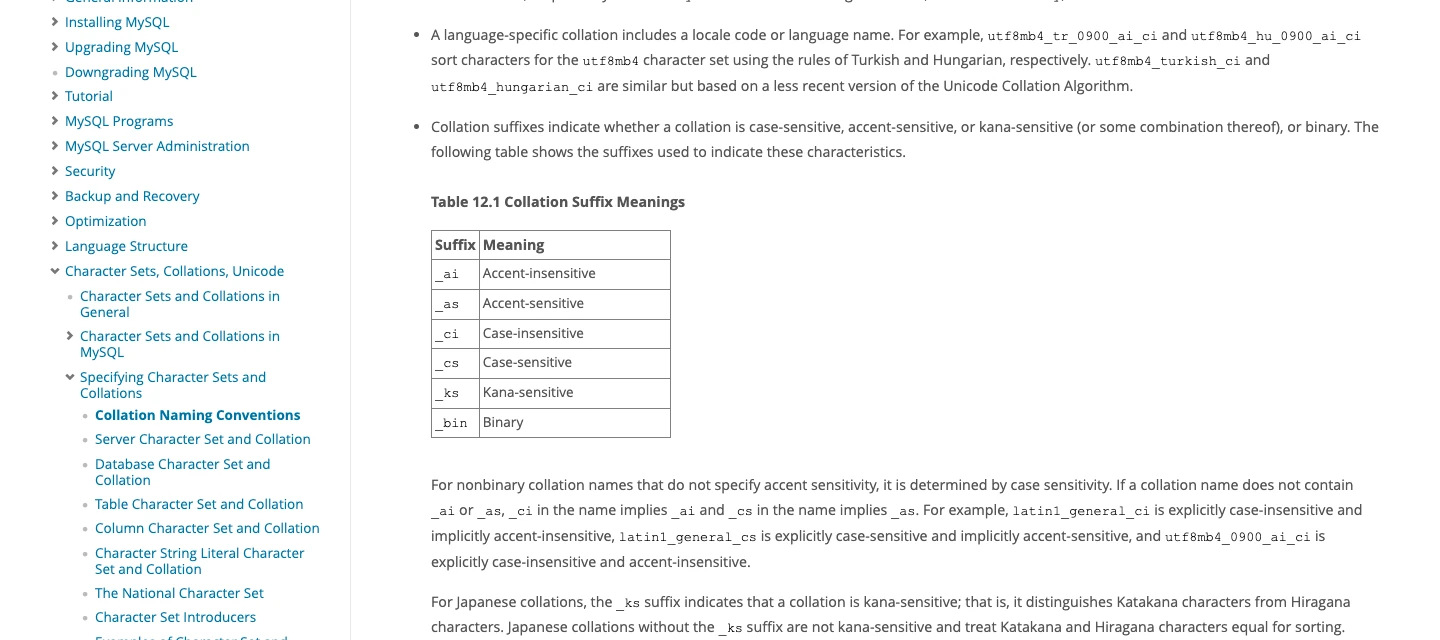
Hậu tố của tên collation giải thích phần lớn bảng: ai là bỏ qua dấu, as là phân biệt dấu, ci là bỏ qua hoa thường, cs là phân biệt hoa thường, bin là so mã nhị phân. Tên không ghi ai hay as thì ci hàm ý ai và cs hàm ý as, nên utf8mb4_general_ci mặc nhiên bỏ qua dấu. MySQL 8.4.8 đặt utf8mb4_0900_ai_ci làm collation mặc định của utf8mb4 (cột Default của SHOW COLLATION ghi Yes).
Hai kết quả đo dưới đây không có trong các trang MySQL mà MONA đã đọc. Một: các collation 0900 và unicode_ci coi NFC và NFD là một, nhưng collation tiếng Việt thì không, với các chữ ê, ô, ơ, ư, ă, â (các chữ có chỗ riêng trong bảng chữ cái). Các chữ chỉ thêm dấu thanh như à, á, hay đ vẫn bằng nhau ở cả hai dạng. Hai: vi_0900_ai_ci coi “Nguyễn” NFD bằng “Nguyen” nhưng khác “Nguyễn” NFC, vì nó đọc e cộng hai dấu rời thành chữ e trơn.
Phép LIKE còn có lỗi riêng. Dấu _ chỉ khớp một mã Unicode, nên LIKE 'Nguy_n' không bao giờ khớp dòng NFD (ê của dòng đó là ba mã). Câu lệnh này trả dòng 1, 3, 4 trên cả utf8mb4_bin, 0900_ai_ci lẫn vi_0900_ai_ci và bỏ dòng 2. Dấu % không gặp lỗi này: LIKE '%ễ%' trên 0900_ai_ci trả cả bốn dòng 1, 2, 3, 4, vì collation này coi ê bằng e ở cả hai dạng.
Tìm các dòng NFD đang nằm trong bảng và viết lại sang NFC
Dữ liệu tiếng Việt dạng NFC không chứa mã nào trong dải dấu kết hợp U+0300 đến U+036F; một câu REGEXP bắt được đúng các dòng NFD:
mysql> SELECT id, HEX(ten) FROM khach WHERE ten REGEXP '[\\x{0300}-\\x{036F}]';
+----+----------------------+
| id | hex(ten)             |
+----+----------------------+
|  2 | 4E67757965CC82CC836E |
|  6 | C49061CCA3CC866E67   |
+----+----------------------+
Trên MySQL 8.4.8, SELECT NORMALIZE('x') báo “FUNCTION blog_lab_unicode.normalize does not exist” (hàm UNICODE_NORMALIZE cũng không có), nên việc chuyển nằm ở code ứng dụng. Python (PyMySQL 1.2.3, mật khẩu trong code thay bằng dấu ba chấm) tìm dòng chưa NFC bằng is_normalized rồi ghi lại:
import unicodedata, pymysql

db = pymysql.connect(host="127.0.0.1", user="root", password="...",
                     database="blog_lab_unicode", charset="utf8mb4", autocommit=True)
cur = db.cursor()

cur.execute("SELECT id, ten FROM khach")
bad = [(i, t) for i, t in cur.fetchall() if not unicodedata.is_normalized("NFC", t)]
print("rows not in NFC:", [i for i, _ in bad])

for i, t in bad:
    cur.execute("UPDATE khach SET ten = %s WHERE id = %s",
                (unicodedata.normalize("NFC", t), i))
print("updated:", len(bad))

rows not in NFC: [2, 6]
updated: 2
Ghi lại xong, hai dòng NFD có cùng mã hex với dòng NFC tương ứng (4E677579E1BB856E cho Nguyễn, C490E1BAB76E67 cho Đặng) và char_length về 6 và 4. Độ dài tính bằng byte cũng co lại, từ 10 xuống 8 với Nguyễn và từ 9 xuống 7 với Đặng. Phép so sánh sau sửa trả kết quả sạch ở mọi collation:
+----------------------+---------+
| c                    | hits    |
+----------------------+---------+
| bin                  | 1,2     |
| vi_0900_ai_ci        | 1,2,4   |
| vi_0900_ai_ci Nguyen | 3       |
| 0900_ai_ci Nguyen    | 1,2,3,4 |
+----------------------+---------+
Dòng 1 và 2 giờ khớp nhau ngay cả ở utf8mb4_bin. Việc còn lại là chặn dòng NFD mới. Gọi unicodedata.normalize("NFC", ...) hoặc hàm tương đương của ngôn ngữ đang dùng, cho cả giá trị ghi vào lẫn chuỗi người dùng gõ vào ô tìm. Chuỗi tìm ở dạng NFD sẽ không khớp dữ liệu NFC ở cột nhị phân. Hàm Python nằm trong unicodedata, tài liệu cảnh báo đúng điều này: hai chuỗi trông giống nhau vẫn có thể so sánh khác nhau nếu một chuỗi dùng ký tự kết hợp.
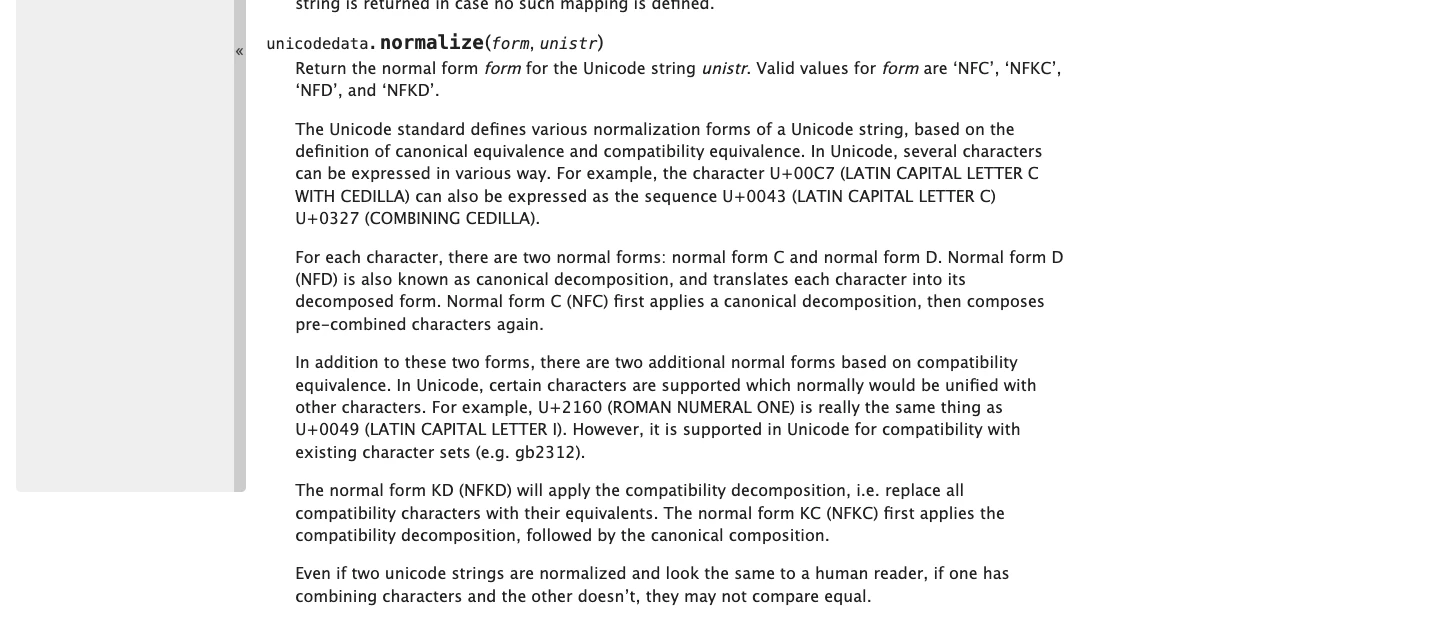
unicodedata.normalize trong tài liệu Python 3.9. Nguồn docs.python.org, chụp ngày 26/10/2026.Cách này hỏng khi có chương trình khác ghi thẳng vào bảng mà không qua code của anh chị, chẳng hạn một công cụ nhập liệu hay một script chạy riêng trên phần mềm quản lý dữ liệu dùng chung. Khi đó dòng NFD vẫn xuất hiện, và đó là một bug của khâu quản lý dữ liệu cần ghi kèm hai dòng mẫu. Dải U+0300 đến U+036F cũng chứa dấu móc U+031B của ơ và ư (Python cho ơ ở dạng NFD là o + U+031B), nên câu REGEXP bắt được cả hai chữ này. Cách kiểm là chạy lại câu REGEXP ở trên theo lịch.
Chọn collation cho tìm không dấu và cho sắp xếp
Tìm “dang” ra “Đặng” cần collation coi đ bằng d. Trong bảng trên chỉ utf8mb4_0900_ai_ci làm được; utf8mb4_unicode_ci và các collation tiếng Việt coi đ khác d. Collation tiếng Việt lại là lựa chọn đúng cho thứ tự sắp xếp, vì đ đứng sau d. Mười tám tên mẫu cho kết quả:
utf8mb4_vi_0900_ai_ci : An Ánh Ân Bảo Bình Dũng Dương Đào Đạt Điệp Hà Hải Hạnh Hằng Thanh Thành Thảo Trần
utf8mb4_0900_ai_ci    : Ân An Ánh Bảo Bình Đào Đạt Điệp Dũng Dương Hà Hải Hằng Hạnh Thanh Thành Thảo Trần
utf8mb4_bin           : An Bình Bảo Dũng Dương Hà Hạnh Hải Hằng Thanh Thành Thảo Trần Ánh Ân Điệp Đào Đạt
Cột vi_0900_ai_ci xếp An, Ánh, Ân và Dũng, Dương, Đào đúng thứ tự tiếng Việt. Cột 0900_ai_ci coi Ân, An, Ánh là bằng nhau và xếp chúng theo id, và Đào đứng trước Dũng. Cột bin xếp theo mã, đẩy Ánh, Ân, Điệp, Đào, Đạt ra sau Trần, và đặt Hạnh trước Hải. Cột utf8mb4_vietnamese_ci (bản UCA cũ hơn) cho đúng thứ tự như vi_0900_ai_ci trên 18 tên này.
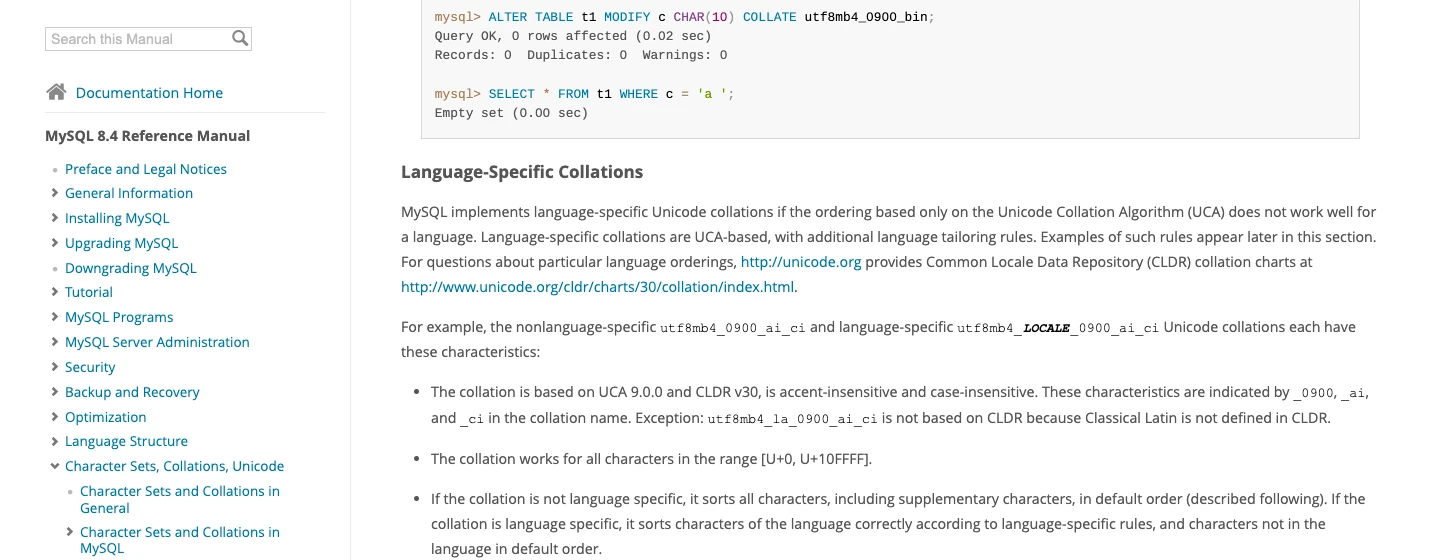
Một cột chỉ có một collation, và ép collation khác vào câu truy vấn làm mất chỉ mục. MONA tạo bảng 50.000 tên với hai cột: ten (vi_0900_ai_ci, để hiển thị và sắp xếp) và ten_tim (0900_ai_ci, để tìm). Cả hai cột có chỉ mục (câu CREATE TABLE dưới đây xuống dòng cho dễ đọc, còn ba dòng cuối là cột type, key, rows của EXPLAIN do một script Python in ra; rows là số ước tính nên đổi giữa các lần chạy):
CREATE TABLE kh(
  id INT AUTO_INCREMENT PRIMARY KEY,
  ten     VARCHAR(60) COLLATE utf8mb4_vi_0900_ai_ci,
  ten_tim VARCHAR(60) COLLATE utf8mb4_0900_ai_ci,
  INDEX(ten), INDEX(ten_tim)
) DEFAULT CHARSET utf8mb4;

ten_tim = 'Nguyen Van An'                         type=ref    key=ten_tim rows=11
ten = 'Nguyen Van An'                             type=ref    key=ten     rows=1
ten COLLATE utf8mb4_0900_ai_ci = 'Nguyen Van An'  type=index  key=ten     rows=49978
EXPLAIN cho ten_tim ước tính 11 dòng, còn ép COLLATE utf8mb4_0900_ai_ci lên cột ten làm MySQL quét 49.978 dòng của chỉ mục. Cột ten với chuỗi “Nguyen Van An” không dấu chỉ ra 0 dòng, trong khi “Nguyễn Văn An” ra 11 dòng. Giá phải trả là một cột thứ hai ghi đôi dữ liệu và một chỗ để quên cập nhật khi sửa tên. Cách này chỉ đáng làm khi bảng đủ lớn để việc quét toàn chỉ mục chậm thấy rõ. Bảng nhỏ thì để một cột utf8mb4_0900_ai_ci và sắp xếp bằng ORDER BY ten COLLATE utf8mb4_vi_0900_ai_ci khi cần.
Hỏi đáp
Nên lưu NFC hay NFD?
NFC. UAX #15 ghi rằng W3C khuyến nghị NFC cho nội dung web, và NFC giữ char_length đúng với số chữ người đọc thấy (Nguyễn là 6 mã ở dạng NFC, 8 mã ở dạng NFD).
MariaDB có giống MySQL 8.4 không?
Chưa kiểm. Các collation utf8mb4_0900_* và utf8mb4_vi_0900_* trong bài là của MySQL 8; trên MariaDB hãy chạy lại bảng đối chiếu ở phần hai bằng tên collation mà bản đang dùng có.
Có cần NFKC không?
Với tên người và địa chỉ thì NFC là đủ. UAX #15 nói NFKC và NFKD (hai dạng chuẩn hóa tương thích, NFKC có ghép lại) “không được áp mù quáng” cho văn bản bất kỳ vì chúng gộp các kiểu chữ (ví dụ chữ toàn rộng và bán rộng) và có thể đổi nghĩa.
Vì sao tìm “dang” không ra “Đặng” ở cột tiếng Việt?
Chữ đ (U+0111) không tách ra được, vì vậy tìm bỏ dấu phải nhờ collation coi đ bằng d. Cột vi_0900_ai_ci coi hai chữ này là khác nhau, cột 0900_ai_ci thì coi là bằng.
Nhập file Excel hay CSV thì chuẩn hóa ở đâu?
Ngay trong script đọc file, trước khi ghi từng ô vào phần mềm quản lý khách hàng hay bảng dữ liệu khác. MONA chưa kiểm xem LOAD DATA có tự chuẩn hóa không; chuẩn hóa trong script là cách đã chạy được. Bài chuyển dữ liệu từ Excel sang phần mềm quản lý nói về cả quy trình nhập. Cột nào đã có dòng NFD thì chạy lại câu REGEXP sau mỗi lần nhập để biết file mới có mang NFD vào hay không.
MONA đưa bước kiểm dạng chuẩn hóa này vào phần mềm viết theo yêu cầu cho doanh nghiệp nhập tên từ file Excel, form và API. Bảng đang có tên tìm không ra thì gọi hotline 1900 636 648 kèm hai dòng mẫu NFC và NFD.