

Chủ một phòng khám muốn AI đọc hồ sơ bệnh nhân để tóm tắt trước buổi khám, một công ty tài chính muốn AI phân loại hàng nghìn hồ sơ vay mỗi ngày, và câu hỏi đầu tiên của cả hai là dữ liệu có rời khỏi công ty không. Cùng lúc, tin “model Trung Quốc đã vượt các hãng Mỹ” lan khắp nơi, kèm những con số rất khác nhau. Model mở Trung Quốc đúng là đang dẫn lượng gọi trên OpenRouter: theo bảng Market Share của chính OpenRouter tra ngày 14/10/2026, các hãng DeepSeek, Z.ai, Qwen, Xiaomi và Tencent cộng lại chiếm 47,9% lượt gọi chữ trong tuần bắt đầu ngày 05/10/2026, còn OpenAI, Google và Anthropic cộng lại là 40,3%. Với doanh nghiệp Việt, điều đáng tính hơn con số đó là chữ “mở”: DeepSeek-V4.1-Flash và GLM-5.3-Flash đều cho tải trọng số theo giấy phép MIT, vì vậy chạy được trên máy chủ đặt tại Việt Nam và dữ liệu ở lại trong nước. Đổi lại, tự host tốn phần cứng và người vận hành, nên chỉ đáng làm cho việc chạm dữ liệu nhạy cảm hoặc chạy khối lượng rất lớn.
Bài này giải thích bảng xếp hạng OpenRouter thật ra đo gì, con số 61% từng lan trên mạng đến từ đâu, model mở mang lại gì cho doanh nghiệp có dữ liệu nhạy cảm, tự host tốn những gì, và cách chia việc giữa tự host với gọi API.
Bảng xếp hạng OpenRouter đang đo lượt gọi của lập trình viên
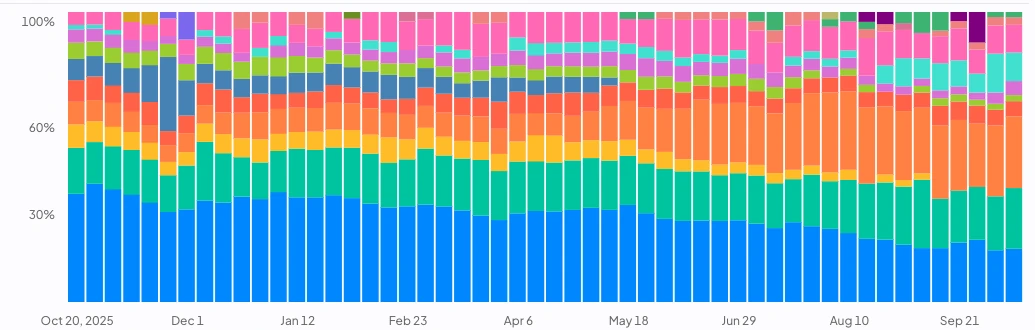
OpenRouter là một cổng trung gian: lập trình viên gửi yêu cầu qua một API duy nhất, cổng chuyển tới model của nhiều hãng. Trang OpenRouter Rankings công khai số liệu đi qua cổng này theo giấy phép CC BY 4.0, gồm bảng xếp hạng model theo số token và biểu đồ Market Share theo hãng làm ra model. Tuần bắt đầu ngày 05/10/2026, phần lượt gọi chữ chia như sau: DeepSeek 24,5%, OpenAI 18,6%, Google 17,8%, Z.ai 13,4%, Qwen 5,4%, Anthropic 3,9%, Xiaomi 2,9%, Mistral AI 2,0%, Tencent 1,7%, các hãng còn lại 9,7%.
| Nhóm hãng | Hãng trong nhóm chín hãng đầu | Phần lượt gọi chữ, tuần từ 05/10/2026 |
|---|---|---|
| Hãng Trung Quốc | DeepSeek, Z.ai, Qwen, Xiaomi, Tencent | 47,9% |
| Ba hãng lớn của Mỹ | OpenAI, Google, Anthropic | 40,3% |
| Hãng châu Âu | Mistral AI | 2,0% |
| Các hãng còn lại, OpenRouter gộp chung | Gồm cả các hãng Trung Quốc khác như StepFun | 9,7% |
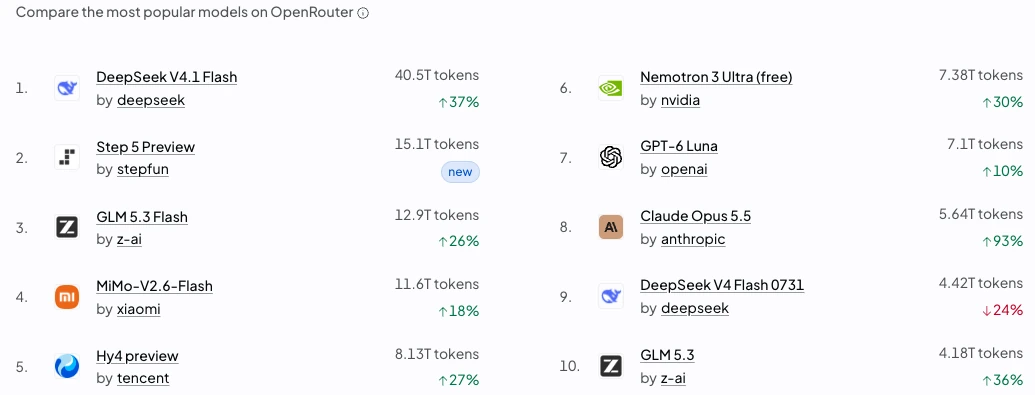
Ngay dưới bảng, OpenRouter ghi rõ biểu đồ Market Share đếm số yêu cầu, còn bảng xếp hạng model đếm số token, và không bảng nào đo số người dùng hay số tiền chi ra. Nói cách khác, đây là lượng gọi của những người dùng chính cổng OpenRouter, phần lớn là lập trình viên và các ứng dụng nhỏ đang tìm model rẻ cho việc lặp lại, chứ chưa cho biết doanh nghiệp lớn đang ký hợp đồng với ai. Ở bảng token tuần này, bảy trong mười model đứng đầu là của hãng Trung Quốc, dẫn đầu là DeepSeek V4.1 Flash với 40,5 nghìn tỷ token.
Con số 61% lan trên mạng không có trên trang OpenRouter
Giữa tháng 9/2026, nhiều trang tổng hợp đưa tin model Trung Quốc chiếm khoảng 61% lượng gọi trên OpenRouter. MONA tra lại nguồn gốc ngày 14/10/2026 và không tìm thấy con số 61% trên trang của OpenRouter. Trang Rankings chỉ công bố phần lượt gọi theo từng hãng, theo từng tuần, và các con số được trích lại thì lệch nhau: có bài ghi 46%, có bài ghi khoảng 58%, có bài dẫn lại báo CNBC với khoảng 57% đến 67% cho tuần 14/09/2026. Mỗi nơi tính một kiểu, có nơi đếm token, có nơi đếm yêu cầu, có nơi chỉ đếm doanh nghiệp Mỹ, có nơi gộp mọi model Trung Quốc kể cả model đóng.
Cách đọc an toàn là lấy thẳng bảng của OpenRouter, ghi rõ tuần nào và đang đếm gì. Theo cách đó, con số tuần 05/10/2026 là 47,9% lượt gọi cho năm hãng Trung Quốc có tên trong bảng, cộng thêm một phần chưa tách được trong nhóm 9,7% còn lại. Xu hướng thì rõ và lớn: hãng Trung Quốc đang chiếm phần lớn lượng gọi trên cổng này. Con số chính xác thì đổi theo từng tuần, nên mọi bài trích con số đều cần kèm ngày tra.
Với doanh nghiệp Việt, chữ “mở” đáng giá hơn chữ “rẻ”
Gọi model Trung Quốc qua API thì dữ liệu vẫn đi ra máy chủ của nhà cung cấp, giống như gọi model Mỹ. Doanh nghiệp đã ngại gửi hồ sơ khách ra nước ngoài thì đổi từ API Mỹ sang API Trung Quốc chưa giải quyết được nỗi lo đó. Thứ thay đổi tình thế là nhiều model trong số này được công bố trọng số. DeepSeek-V4.1-Flash có trang trên Hugging Face ghi rõ kho mã và trọng số model dùng giấy phép MIT, khoảng 552 tỷ tham số khung chính, kèm lệnh chạy mẫu bằng vLLM và SGLang. GLM-5.3-Flash của Z.ai cũng dùng giấy phép MIT, 320 tỷ tham số tổng với 18 tỷ tham số hoạt động mỗi lượt.
Giấy phép MIT cho phép dùng thương mại, sửa đổi và chạy trong hạ tầng riêng. Doanh nghiệp tải trọng số về, dựng trên máy chủ đặt tại Việt Nam, và mọi hồ sơ, hợp đồng, đoạn chat của khách chỉ đi trong mạng nội bộ. Với các ngành giữ dữ liệu nhạy cảm như y tế, tài chính, pháp lý, đây là lần đầu câu hỏi “dữ liệu có ra nước ngoài không” có câu trả lời dứt khoát mà vẫn dùng được model đủ mạnh cho việc thường ngày. Câu hỏi đó gắn trực tiếp với nghĩa vụ trong Nghị định 356/2025 về dữ liệu cá nhân và Luật An ninh mạng 2025, nhất là khi dữ liệu khách được chuyển ra ngoài lãnh thổ.
Còn nếu chỉ cần rẻ mà dữ liệu không nhạy cảm, gọi API vẫn là đường ngắn nhất. Trang giá của DeepSeek tra ngày 14/10/2026 ghi model deepseek-flash, tức DeepSeek-V4.1-Flash, tính 0,15 USD mỗi triệu token đầu vào và 0,60 USD đầu ra ở giờ thấp điểm, gấp đôi ở giờ cao điểm. Giờ cao điểm là 01:00 đến 04:00 và 06:00 đến 10:00 giờ UTC từ thứ Hai đến thứ Sáu, tức 8 giờ đến 11 giờ và 13 giờ đến 17 giờ theo giờ Việt Nam, đúng giờ làm việc của doanh nghiệp trong nước.
Tự host model mở tốn những gì
Giá API mà các bài báo hay dẫn là giá gọi qua hãng, chưa phải giá tự host. Khi tự chạy, tiền chuyển sang ba chỗ: phần cứng, điện và người vận hành. Phần cứng tính được từ số tham số. GLM-5.3-Flash có 320 tỷ tham số; ở định dạng 8-bit mỗi tham số tốn một byte, nên riêng trọng số đã khoảng 320 GB, chưa tính bộ nhớ đệm cho ngữ cảnh dài. Một card GPU loại 80 GB bộ nhớ thì cần ít nhất bốn card chỉ để nạp trọng số, thực tế phải nhiều hơn để chạy nhiều yêu cầu cùng lúc. DeepSeek-V4.1-Flash còn lớn hơn.
Người vận hành là khoản hay bị quên. Máy chủ AI cần người theo dõi tải, cập nhật bản vá, xử lý khi card lỗi giữa giờ cao điểm, đổi phiên bản model khi hãng ra bản mới, và giữ nhật ký truy cập dữ liệu để đối chiếu khi cần. Một đội chưa có ai lo hạ tầng mà kỳ vọng tự host chạy êm như gọi API là đặt kỳ vọng sai. Bài AI local hay tài khoản AI cho doanh nghiệp có bảng so chi phí giữa mua máy chạy AI và trả thuê bao.
Cũng có hướng nhẹ hơn: các model mở nhỏ chạy được trên một máy chủ đơn, đổi lại chất lượng thấp hơn. Bài Ternary Bonsai 2 27B nặng 5,9 GB chạy tại chỗ, bài Qwen3.8-Flash-Next mở trọng số và bài MiMo-V2.6 mở trọng số theo MIT đi qua từng lựa chọn cỡ nhỏ và vừa. Với tiếng Việt, nhất là hội thoại tổng đài có nhiều cách nói vòng, model mở nhỏ thường còn kém model lớn; cách MONA chấm một model trên việc tổng đài tiếng Việt nằm ở bài nghiên cứu chấm Gemini trên việc tổng đài tiếng Việt.
Chia việc AI trong doanh nghiệp thành hai nhóm trước khi chọn model
Chọn theo từng việc thay vì theo tiêu đề tin tức. Một cách chia dễ dùng là hai nhóm. Nhóm thứ nhất là việc chạm dữ liệu nhạy cảm hoặc chạy khối lượng rất lớn, đơn giản và lặp lại: tóm tắt hồ sơ, phân loại đơn, tra cứu tài liệu nội bộ. Nhóm này hợp với model mở tự host trong nước, vì dữ liệu không đi đâu và hoá đơn không tăng theo lượt gọi. Nhóm thứ hai là việc cần suy luận khó, tiếng Việt thật mượt, ít đụng dữ liệu nhạy cảm, như viết nội dung tiếp thị hay trả lời câu hỏi phức tạp; nhóm này vẫn hợp với API của model mạnh.
Thứ tự làm cụ thể:
- Liệt kê mọi việc AI đang chạy hoặc định chạy trong công ty, ghi rõ mỗi việc đọc dữ liệu gì và chạy bao nhiêu lượt mỗi ngày.
- Khoanh những việc đọc dữ liệu cá nhân, hồ sơ khách, hợp đồng hoặc số liệu tài chính; đây là danh sách đáng xét tự host trước.
- Với từng việc trong danh sách đó, ước lượng số token mỗi tháng và so với chi phí phần cứng cộng người vận hành trong 12 tháng.
- Chạy thử model mở trên một bộ 50 đến 100 ca thật đã có kết quả đúng, đếm số ca sai trước khi quyết định.
- Thiết kế phần mềm để tên model và địa chỉ máy chủ nằm trong cấu hình, chuyển qua lại giữa tự host và API mà không sửa code.
- Giữ nhật ký mỗi lượt gọi: model nào, ai gọi, đọc dữ liệu gì, để trả lời được khi kiểm tra tuân thủ.
Bước thứ năm giúp tránh bị khoá vào một lựa chọn. Bảng xếp hạng đổi theo tuần, model mới ra theo tháng, và một phần mềm đổi model bằng cấu hình thì luôn chọn lại được khi tình hình thay đổi. Các lớp quyền và nhật ký cho AI Agent được nói kỹ hơn ở bài AI Agent là gì.
Hỏi đáp
Model Trung Quốc chiếm bao nhiêu phần trăm lượt gọi trên OpenRouter?
Theo bảng Market Share của OpenRouter tra ngày 14/10/2026, năm hãng DeepSeek, Z.ai, Qwen, Xiaomi và Tencent chiếm 47,9% lượt gọi chữ trong tuần bắt đầu 05/10/2026, chưa tính các hãng Trung Quốc nằm trong nhóm “còn lại” 9,7%.
Con số 61% có đúng không?
Con số này không có trên trang OpenRouter. Nó đến từ các bài tổng hợp, mỗi nơi tính theo một cách và một tuần khác nhau, với các mức từ 46% đến 67%. Khi trích, nên lấy thẳng bảng của OpenRouter và ghi rõ tuần.
Gọi API DeepSeek thì dữ liệu có ra nước ngoài không?
Có. Gọi qua API là gửi dữ liệu tới máy chủ của nhà cung cấp. Muốn dữ liệu ở lại trong nước thì phải tải trọng số model mở về chạy trên máy chủ đặt tại Việt Nam.
Model mở nào dùng được cho mục đích thương mại?
DeepSeek-V4.1-Flash và GLM-5.3-Flash đều ghi giấy phép MIT trên trang Hugging Face, cho phép dùng thương mại và chạy trong hạ tầng riêng. Mỗi model có giấy phép riêng, vì vậy cần đọc trang của từng model trước khi dùng.
Tự host GLM-5.3-Flash cần phần cứng cỡ nào?
Model có 320 tỷ tham số, ở định dạng 8-bit riêng trọng số khoảng 320 GB, nghĩa là ít nhất bốn GPU loại 80 GB chỉ để nạp model, cộng thêm bộ nhớ cho ngữ cảnh và số yêu cầu chạy cùng lúc.
Chọn giữa tự host và gọi API là quyết định theo từng việc, và phần mềm cần được viết để đổi được khi tình hình thay đổi. MONA viết phần mềm theo yêu cầu, AI Agent cho quy trình riêng và chatbot AI cho doanh nghiệp với lớp chọn model tách riêng, chạy được với model tự host trong nước hoặc API tuỳ từng việc. Doanh nghiệp đang có dữ liệu nhạy cảm và muốn biết việc nào nên giữ trong nhà có thể gọi hotline 1900 636 648 để MONA cùng rà danh sách việc AI hiện có.